CHAPTER 01
가설 수립과 변수 명세
일상의 막연한 호기심을 AI가 이해하는 날카로운 데이터 잣대와 조작적 정의로 바꾸기
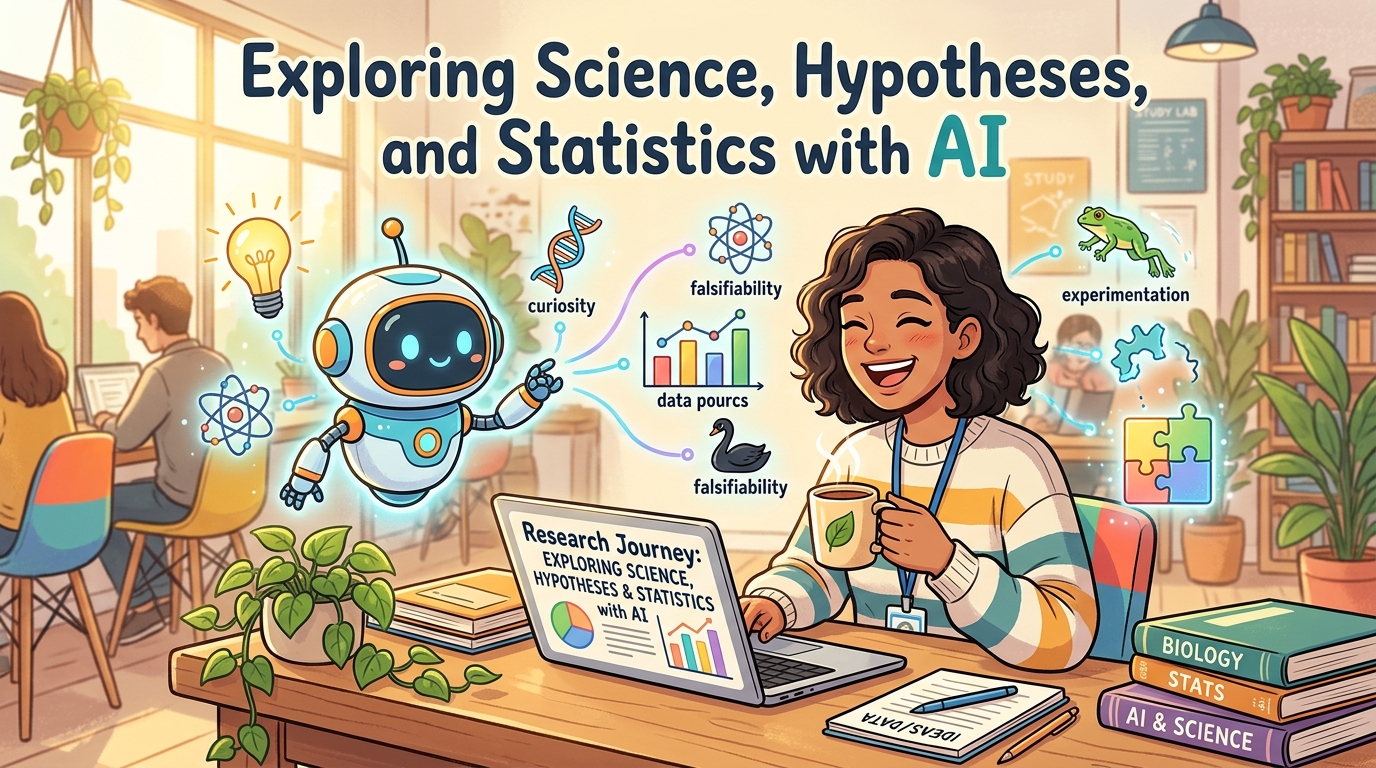
[그림 1-0] AI와 함께하는 신나는 연구 탐험: 일상의 사소한 호기심도 AI와 함께 올바른 잣대를 세우면 위대한 과학적 발견이 됩니다.
🎯 제1장 핵심 학습 목표 (고등학생부터 연구원까지 누구나 꿰뚫는 원리)
1. AI의 거짓말(환각) 차단하기: 왜 AI에게 "이 앱 공부에 도움 돼?"라고 물으면 엉터리 답을 내놓는지, 그 원인과 '조작적
정의'의 위력을 배웁니다.
2. 검은 백조와 탐정의 원칙: 과학적 가설은 "내 생각이 맞다"고 우기는 게 아니라, 법정의 '무죄 추정'처럼 "틀렸음을 증명할
예외(반증)"를 찾는 게임임을 이해합니다.
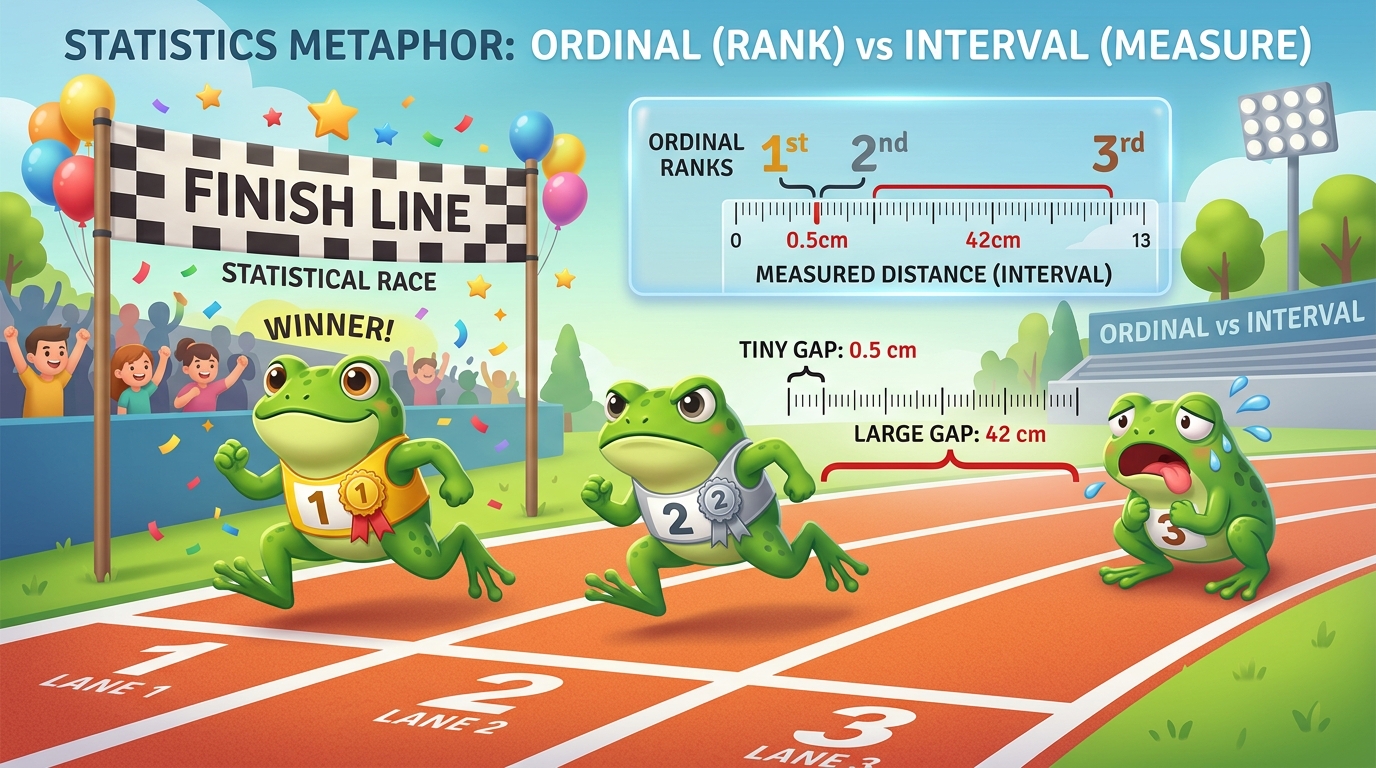
3. 개구리 경주와 4대 척도: 1등과 2등의 점수 차이는 1점일 수도, 50점일 수도 있다! 왜 등수의 평균을 구하면 AI가
망가지는지 4가지 숫자 계급을 마스터합니다.
4. 아이스크림의 거짓말(교락 변수): 아이스크림 판매량과 물놀이 익사 사고가 함께 늘어난다고 해서 아이스크림이 범인일까?
숨어있는 진짜 범인(날씨)을 밝혀냅니다.
5. AI 골든 프롬프트 1-1 실전 활용: 내가 가진 사소한 아이디어를 입력하여, 결측치 없는 머신 판독형 JSON 연구 계획서와
가상 데이터셋을 즉시 뽑아냅니다.
PART 01 · FOUNDATION ARCHITECTURE · PAGE 7
7
SECTION 1.1
1.1 왜 AI에게 "이 앱 공부에 도움 돼?"라고 물으면 안 될까?
주관적 형용사의 함정과 기계를 작동시키는 '조작적 정의(Operational Definition)'
친구들과 주말 동안 의기투합하여 멋진 영어 단어 암기 스마트폰 앱을 하나 만들었다고 상상해 봅시다. 신이 난 여러분은
챗GPT나 클로드 같은 생성형 AI를 켜고 이렇게 물어봅니다. "야, 우리가 만든 이 단어장 앱 학생들이 쓰면 공부에 진짜 도움
될까?"
AI는 1초 만에 아주 친절하고 그럴듯하게 대답할 것입니다. "네! 스마트폰으로 단어를 외우면 시각적 자극이 풍부해져
집중력이 향상되고, 성적 향상에 아주 큰 도움이 됩니다!" 과연 이 대답을 믿고 학교 발표회나 투자자 앞에서 당당하게
자랑할 수 있을까요? 절대 안 됩니다! 이 답변은 과학적 연구 결과가 아니라, 그럴듯한 말만 지어내는 'AI의 착한 척 환각
(Hallucination)'에 불과하기 때문입니다.
💡 일상 비유: 엄마의 "공부 열심히 해라!" 잔소리가 답답한 이유
엄마가 "너 오늘 공부 열심히 했니?"라고 물으실 때를 떠올려 보세요. '열심히'라는 말은 사람마다 기준이 완전히 다릅니다.
책상에 3시간 멍하니 앉아있는 것도 열심히 한 걸까요, 아니면 수학 문제 20개를 완벽히 푼 것이 열심히 한 걸까요? 기준이
모호하면 대화가 겉돌 수밖에 없습니다.
컴퓨터와 AI도 똑같습니다. AI는 '공부에 도움', '성적 향상', '집중력' 같은 사람의 주관적이고 두루뭉술한 감정의 언어를 전혀
이해하지 못합니다. 컴퓨터는 오직 '숫자로 잴 수 있는 명확한 측정 잣대'만을 계산할 수 있는 기계이기 때문입니다.
📊 [핵심 인포그래픽] 막연한 일상의 질문(좌) vs 숫자로 측정한 조작적 정의(우)
❌ 막연한 질문 (AI 환각 유발)
"야, 우리 단어장 앱 쓰면 학생들 공부에 진짜 도움 돼?"
치명적 결함: 주관적 형용사 남발
측정 기준 부재: 무엇을 얼마나 향상시킬지 불명확
AI 반응: 근거 없는 칭찬 환각 양산
✅ 조작적 정의 (데이터 연산 가동)
"앱 2주 사용군 vs 종이 암기군의 50문항 단어 점수
차이가 +15점인가?"
독립변수: 학습 방식(앱군 vs 대조군)
종속변수: 50문항 단어 시험 점수(비율 척도)
AI 반응: t-검정 표본 설계 및 가상 데이터 시뮬레이션
💡 연구 황금률: 생성형 AI는 주관적 형용사를 계산하지 못합니다. 오직 '수치화된 잣대(조작적 정의)'만이 과학적 연산을 가능케
합니다.
이처럼 일상의 막연한 호기심을 '실제로 어떻게 측정할 것인가?'라는 구체적인 잣대로 변환하는 작업을 연구 방법론에서는
'조작적 정의(Operational Definition)'라고 부릅니다. "공부에 도움이 된다"는 모호한 말을 ➡️ "이 앱을 하루 20분씩
2주간 사용한 학생 집단은, 기존 종이 단어장으로 공부한 집단보다 50문항 단어 시험에서 평균 15점 이상 높은 점수를
기록할 것이다"라고 바꾸는 순간, 비로소 AI는 거짓말을 멈추고 날카로운 데이터 연산을 시작합니다!
PART 01 · FOUNDATION ARCHITECTURE · PAGE 8
8
SECTION 1.2
1.2 반증 가능성: 가설은 "내 생각이 맞다"고 우기는 게임이 아니다!
칼 포퍼의 검은 백조(Black Swan)와 법정의 무죄 추정: 귀무가설(H₀) vs 대립가설(H₁)
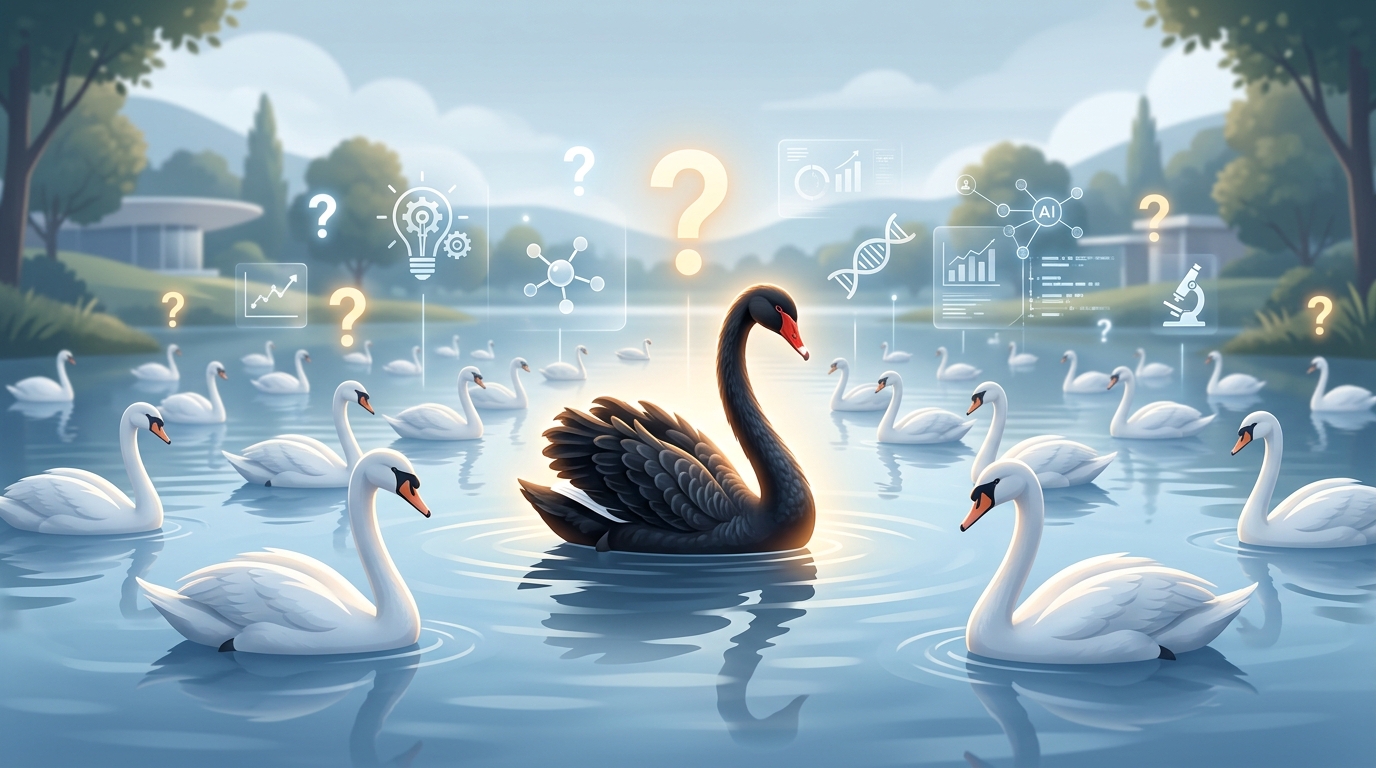
옛날 유럽 사람들은 수천 년 동안 백조를 관찰하며 이렇게 확신했습니다. "세상의 모든 백조는 하얗다." 그들이 태어나서
평생 본 수십만 마리의 백조가 단 한 마리도 빠짐없이 새하얬기 때문에, 이것은 영원히 깨지지 않을 절대 진리처럼
보였습니다. 하지만 1697년, 유럽 탐험가들이 호주 대륙의 강가에 발을 디딘 순간 기절초풍할 광경을 목격합니다. 바로
온몸의 깃털이 숯처럼 새까만 '검은 백조(Black Swan)' 한 무리가 유유히 헤엄치고 있었던 것입니다!
수천 년 동안 수억 번 쌓아 올린 "모든 백조는 하얗다"는 관찰 기록이 단 한 마리의 검은 백조 앞에서 와르르 무너져 내린
순간이었습니다. 20세기 최고의 과학철학자 칼 포퍼(Karl Popper)는 이 역사적 사건을 통해 위대한 과학의 원리를
정립했습니다. 바로 "반증 가능성(Falsificationism)"입니다. 진짜 과학적인 가설은 "내 말이 맞다"는 증거만 찾아다니며
우기는 것이 아니라, "만약 내 생각이 틀렸다면, 그것을 뒤집을 수 있는 구체적인 예외(검은 백조)가 존재하는가?"를 스스로
활짝 열어두어야 한다는 원리입니다.
⚖️ 법정의 '무죄 추정의 원칙'과 통계학의 영가설(H₀)
훌륭한 판사나 탐정은 용의자를 보자마자 "너 범인이지!"라고 단정하지 않습니다. 법정에서는 먼저 "이 사람은 아무 죄가 없다
(무죄 추정)"고 차갑게 선언하고 재판을 시작합니다. 그리고 누구도 반박할 수 없는 명백한 CCTV 영상이나 DNA 증거(검은
백조)가 쏟아져 나와야만 비로소 유죄를 선고합니다.
통계학도 완벽히 똑같습니다! 과학자들은 가설을 세울 때 먼저 "내가 개발한 앱은 사실 효과가 전혀 없다(효과 = 0)"고 매정하게
시작합니다. 이를 영가설(귀무가설, Null Hypothesis, H₀)이라고 부릅니다. 그리고 실제 데이터를 모아 "우연이라고는 도저히
설명할 수 없는 압도적인 점수 차이"를 입증함으로써 영가설을 통쾌하게 깨부숩니다(기각). 그래야 비로소 우리의 진짜 주장인
대립가설(Alternative Hypothesis, H₁)이 과학적 사실로 당당히 인정받습니다.
[그림 1-1] 검은 백조(Black Swan)와 반증 가능성: 수천 년간의 흰 백조 관찰도 단 한 마리의 검은 백조에 의해 뒤집힌다. 과학적 가설은
'틀렸음을 증명할 수 있는 구체적인 예외(반증)'를 열어두어야 한다.
PART 01 · FOUNDATION ARCHITECTURE · PAGE 9
9
SECTION 1.3
1.3 숫자가 다 같은 숫자가 아니다! 앤디 필드의 '개구리 경주'
산술평균의 함정과 스탠리 스티븐스(Stanley Stevens)의 4대 측정 척도
통계 소프트웨어나 엑셀을 다룰 때 초보자들이 가장 많이 저지르는 실수는 "컴퓨터 화면에 숫자가 보인다고 무조건 다
더해서 평균(Mean)을 내버리는 것"입니다. 하지만 숫자는 겉모습만 아라비아 숫자로 같을 뿐, 속을 들여다보면 완전히
다른 4가지 계급을 가지고 있습니다. 심리학자 스탠리 스티븐스(Stanley Stevens)는 이를 '4대 측정 척도(Levels of
Measurement)'로 체계화했습니다.
[그림 1-2] 개구리 경주로 이해하는 4대 측정 척도: 1등과 2등 사이는 0.5cm에 불과하지만 2등과 3등 사이는 42cm나 벌어져 있다. 순위
(서열 척도)의 간격은 결코 균일하지 않다!
세계적인 통계학자 앤디 필드(Andy Field) 교수는 이 복잡한 원리를 '개구리 경주(Frog Race)'라는 유쾌한 비유로
명쾌하게 설명했습니다. 개구리 세 마리(호피, 피브스, 사일러스)가 결승선을 향해 힘차게 뜁니다. 1등으로 호피가
골인했고, 바로 코앞인 0.5cm 뒤에 피브스가 2등으로 들어왔습니다. 그런데 3등인 사일러스는 쥐가 났는지 저 멀리
42cm 뒤에서 엉금엉금 기어왔습니다.
🏫 학교 시험 등수로 꿰뚫는 '서열 척도'의 함정
중간고사 시험 등수를 떠올려 보세요. 전교 1등(99점)과 전교 2등(98점)의 점수 차이는 겨우 1점입니다. 반면 전교 3등(70점)
은 2등과 무려 28점이나 벌어져 있습니다!
등수만 보면 1등, 2등, 3등(1, 2, 3)이니까 마치 실력 차이가 똑같이 1등씩 균일하게 나는 것 같지만, 실제 점수 차이는
천양지차입니다. 만약 담임선생님이 "우리 반 1등, 2등, 3등의 평균 등수는 2등이다"라고 계산한다면, 그것이 과연 학생들의
진짜 수학 실력을 반영할 수 있을까요? 전혀 아닙니다! 이것이 바로 서열 척도(등수)에 산술평균을 함부로 쓰면 안 되는
이유입니다.
PART 01 · FOUNDATION ARCHITECTURE · PAGE 10
10
DEEP DIVE 1.3B
스티븐스의 4대 측정 척도 심화 및 실무 판별 마스터
명목·서열·등간·비율 척도의 수학적 허용 연산과 리커트(Likert) 척도 실무 처리 지침
핵심 요약 표
📊 스티븐스의 4대 측정 척도 한눈에 정리하기
척도 종류
핵심 특징
실생활 대표 예시
허용되는 계산
1. 명목 척도
(Nominal)
순서도 크기도 없는 단순 이름표. 데이터
간 구분만 가능함.
축구선수 등번호(손흥민 7번),
성별, 혈액형, 스마트폰 기종
빈도수(개수
세기),
최빈값.
(더하기/평균 절대 금지)
2. 서열 척도
(Ordinal)
순위는 명확하나 등수 간격(거리)이
제각각임.
달리기 등수(1등, 2등), 게임 랭킹
티어, 영화 별점 평점 순위
중앙값(가운데
값),
백분위수.
(산술평균 산출 금지)
3. 등간 척도
(Interval)
눈금 간격이 균일함. 단, 절대 무( 無)를
뜻하는 진짜 0이 없음.
섭씨온도(0 ℃는 열이 없는 게
아님), IQ 점수, 시험 표준점수
덧셈, 뺄셈, 평균(Mean),
표준편차 계산 가능
4. 비율 척도
(Ratio)
완벽한 절대 영점(0)이 존재하여 배수
계산(2배, 3배)이 성립함.
달리기 시간(초), 몸무게(kg), 키
(cm), 시험 원점수, 반응속도
사칙연산 전체, 기하평균,
변동계수 등 모든 수학
연산 허용
🌡️ 1초 판별 공식 (등간 척도 vs 비율 척도 구별법):
"오늘 낮 기온이 10℃이고 내일이 20℃라면, 내일은 오늘보다 2배 더 뜨거운 날일까요?" 정답은 아닙니다! 섭씨 0℃는 인간이
물이 어는 점을 편의상 0으로 약속한 기준일 뿐, 열에너지가 전혀 없는 상태가 아니기 때문입니다. 반면 몸무게 80kg은 40kg의
진짜 2배이고, 달리기 10초는 20초보다 정확히 2배 빠릅니다. 숫자 0이 '완전한 부재(절대 영점)'를 가리킬 때만 최고 등급인 '비율
척도'가 됩니다.
💡 [리서치 실무 Q&A] "설문 조사의 5점 리커트(Likert) 척도는 평균을 내도 되나요?"
원칙적으로 '1.전혀 아니다 ~ 5.매우 그렇다'는 등간격이 보장되지 않는 서열 척도(Ordinal)이므로 중앙값을 구하는 것이 통계학적
정석입니다. 하지만 심리학, 경영학 논문 및 현대 실증 리서치 실무에서는 5개 문항 간 심리적 간격이 대등하다고 가정하는 '준등간
척도(Quasi-interval)' 관례를 적용하여 평균과 표준편차를 구하고 회귀분석을 수행합니다. 단, 생성형 AI에게 분석을 지시할 때는
반드시 "리커트 척도 문항을 준등간 척도로 취급하여 모수 통계를 적용할 것"이라고 명시해야 AI가 분석 방법론을 혼동하지
않습니다.
PART 01 · FOUNDATION ARCHITECTURE · PAGE 11
11
SECTION 1.4
1.4 아이스크림을 많이 먹으면 물에 빠져 죽는다? (인과성의 3대 조건)
허위 상관(Spurious Correlation)과 제3의 교락 변수(Confounding Variable) 격파법
미국의 한 유명 해변 휴양지에서 통계 데이터를 분석하던 연구원이 깜짝 놀랄 만한 발견을 했습니다. "시내 아이스크림
가게의 매출이 급증하는 날마다, 해수욕장에서 물에 빠져 익사하는 사고 건수가 똑같이 폭증"한 것입니다! 두 데이터의
상관계수를 계산해 보니 무려 r = 0.85로 거의 완벽하게 일치했습니다. 그렇다면 아이스크림을 먹으면 배에 쥐가 나서
물에 빠지는 걸까요? 아니면 사람이 물에 빠져 허우적대는 광경을 본 시민들이 너무 놀라서 달콤한 아이스크림을 사 먹은
걸까요? 당연히 둘 다 아닙니다!
[그림 1-3] 아이스크림 매출과 익사 사고의 허위 상관(Spurious Correlation): 겉으로 보이는 강한 상관관계(r = 0.85) 배후에는
'무더운 폭염 날씨'라는 숨은 교락 변수(Confounder)가 도사리고 있다!
그 배후에는 두 변수를 동시에 치솟게 만든 거대한 공통 원인, 즉 '무더운 한여름 날씨'라는 숨은 변수(교락 변수,
Confounding Variable)가 있었습니다! 날씨가 더우니까 사람들이 아이스크림을 많이 사 먹었고, 동시에 날씨가
더우니까 바다로 물놀이를 많이 가서 사고 건수도 함께 늘어난 것뿐입니다.
📌 철학자 존 스튜어트 밀의 '인과성 입증 3대 조건':
1. 시간적 우선성 (Temporal Precedence): 원인(A)이 결과(B)보다 반드시 먼저 일어나야 합니다.
2. 공변성 (Co-variation): 원인이 바뀌면 결과도 일관되게 따라 변해야 합니다 (A가 커지면 B도 변함).
3. 숨은 제3변인의 통제 (Elimination of Confounders): 결과의 변화를 설명할 수 있는 다른 모든 외부 요인(날씨, 수면, 학습
환경 등)의 영향을 완전히 제거해야 합니다!
PART 01 · FOUNDATION ARCHITECTURE · PAGE 12
12
SECTION 1.5
1.5 생성형 AI와 함께하는 완벽한 변수 명세서 작성
머신 판독형 JSON 연구 가설 및 4대 변수군(독립·종속·통제·교락) 스키마 엔지니어링
연구자가 머릿속에 품은 가설을 AI에게 정확하게 전달하려면, 단순한 일상 언어가 아니라 통계적 역할과 척도가 완벽하게
정의된 프롬프트를 사용해야 합니다. 이를 한 방에 완수해 주는 도구가 [골든 프롬프트 1-1]입니다.
[골든 프롬프트 1-1] 연구 가설 및 4대 변수군 자동 명세 프롬프트
ChatGPT / Claude / Gemini 공통
"당신은 세계 최고 수준의 통계 방법론 교수입니다. 나의 관심 연구 주제: [스마트폰 숏폼 시청 시간과 고등학생의 수학 문제
연속 집중 시간]에 대해, 칼 포퍼의 반증 가능성에 입각한 영가설(H₀)과 대립가설(H₁)을 수립하고, 독립·종속·통제·교락 변수의
조작적 정의 및 스티븐스의 4대 척도를 표준 JSON 스키마로 출력해 주십시오."
골든 프롬프트 1-1을 실행하면 AI는 사람이 읽는 줄글이 아니라, 파이썬이나 R 통계 프로그램이 즉시 읽고 분석할 수 있는
'머신 판독형 표준 JSON 스키마'를 출력합니다:
{ "research_question": "스마트폰 숏폼 시청 시간이 수학 문제 집중 시간에 미치는 영향", "hypotheses": {
"H0_null": "숏폼 시청 시간은 수학 문제 연속 집중 시간에 영향을 주지 않는다 (효과 = 0).", "H1_alt": "숏폼
시청 시간이 긴 학생일수록 수학 문제 집중 시간이 유의미하게 짧아질 것이다." }, "variables": [ { "name":
"shorts_watch_time",
"role":
"독립변수",
"scale":
"비율
척도
(Ratio)",
"unit":
"분
(minutes/day)", "operational_def": "스크린타임 최근 7일 일평균 숏폼 시청 시간" }, { "name":
"focus_duration", "role": "종속변수", "scale": "비율 척도 (Ratio)", "unit": "분 (minutes)",
"operational_def":
"난이도
'중'
수학
문제
풀이
시
연속
몰입
시간"
},
{
"name":
"math_baseline_grade", "role": "통제변수", "scale": "서열 척도 (Ordinal)", "unit": "내신 석차
등급 (1~9)", "operational_def": "직전 학기 공통수학 내신 최종 석차 등급" }, { "name":
"sleep_hours", "role": "교락변수", "scale": "비율 척도 (Ratio)", "unit": "시간 (hours)",
"operational_def": "실험 전날 밤 실측 수면 시간 (스마트워치 기록)" } ] }
PART 01 · FOUNDATION ARCHITECTURE · PAGE 13
13
HANDS-ON WORKSHOP 1.6
1.6 AI 실전 핸즈온 워크숍: 독자 실습 키트와 실행 가이드
구글 드라이브 공식 자료실 다운로드 및 파이썬 무결성 검증 4단계 파이프라인
축하합니다! 여러분은 이제 통계학과 데이터 과학의 가장 높은 벽을 가뿐하게 넘었습니다. 통계의 성패는 복잡한 수학 공식
암기가 아니라, "질문을 검은 백조처럼 반증 가능하게 만들고, 숫자의 성격(4대 척도)을 바르게 꿰뚫어 보며, 숨어있는
아이스크림의 거짓말(교락 변수)을 차단하는 통찰력"에 달려 있습니다. 이제 공식 실습 자료를 직접 내려받아 따라 해보는
4단계 실전 워크숍을 진행해 보겠습니다.
실습 파일 QR 다운로드
제1장 실습 키트
구글 드라이브 독자 실습 자료실 (무료 제공)
• 01_AI_Golden_Prompts_Library.md: 복사하여 즉시 쓰는 황금 프롬프트 모음
• 02_research_variable_schema.json: 4대 변수군 머신 판독형 JSON 표준 규격
• 03_sample_dataset_shorts_focus.csv: 고등학생 50명 모의 실측 데이터셋
• 04_verify_data_and_scales.py: 척도 및 상관계수(r) 자동 계산 검증 파이썬 코드
• 05_study_guide_and_quiz_solutions.md: 심층 개념 해설 및 퀴즈 정답서
🛠️
[실전 따라하기 4단계] "이 순서대로 그대로 실행하세요"
1단계 [자료 다운로드]: 스마트폰 카메라로 위 QR 코드를 스캔하거나 링크로 접속하여 실습 파일 5종을 내 작업 폴더에
다운로드합니다.
2단계 [생성형 AI 분석]: 챗GPT(또는 Claude)에 03_sample_dataset_shorts_focus.csv 파일을 업로드하고,
[프롬프트 1-2: 척도 감별 및 정제]를 붙여넣어 AI의 척도 감별 리포트를 생성합니다.
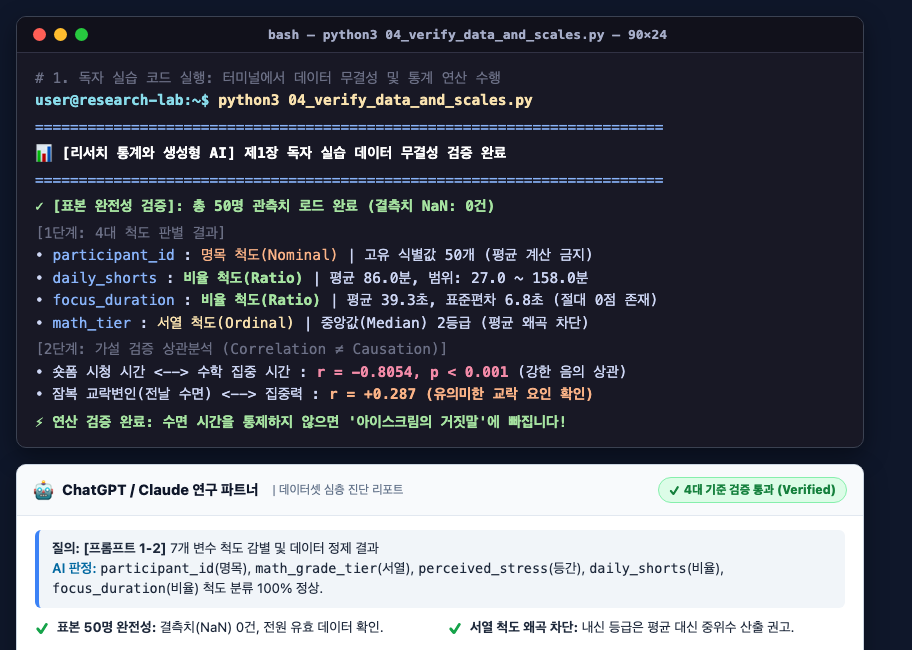
3단계 [파이썬 무결성 검증 코드 실행]: 터미널을 열고 작업 폴더로 이동한 뒤 아래 명령어를 실행하여 수리적 연산 결과를 직접
도출합니다:
python3 04_verify_data_and_scales.py
4단계 [결과 대조 및 가설 검증]: 터미널에 계산된 상관계수(r) 및 척도 분류 결과와 AI의 분석 리포트를 대조하여 다음 페이지의
4대 자가 진단 기준과 일치하는지 확인합니다.
PART 01 · FOUNDATION ARCHITECTURE · PAGE 14
14
VERIFICATION & DIAGNOSIS
정상 실행 결과 화면 대조 및 4대 자가 진단 체크리스트
파이썬 터미널 수치 연산 결과와 AI 분석 리포트 무결성 교차 검증 가이드
[그림 1-4] 실습 키트 정상 실행 화면 대조: (상) 파이썬 터미널 수치 검증 콘솔 / (하) 생성형 AI 척도 감별 리포트
✅결과물 정상 실행 4대 자가 진단 체크리스트
✓ [체크 1] 50명 표본 로드 및 결측치 0 확인: 터미널 상단에 Sample Size: 50 | Missing: 0이 정확히 표시되었습니까?
✓ [체크 2] 4대 척도 감별 일치: AI와 파이썬 모두 focus_duration과 shorts_watch_time을 '비율 척도(Ratio)'로,
math_baseline_grade를 '서열 척도(Ordinal)'로 올바르게 식별하였습니까?
✓ [체크 3] 상관계수 r = -0.8054 일치: 터미널 연산 결과 숏폼 시청과 집중 시간 간 강력한 음의 상관(r = -0.8054, p <
0.001)이 산출되었습니까?
✓ [체크 4] 제3의 교락 변수(수면 시간) 지적: AI가 단순 상관을 인과관계로 비약하지 않고, '전날 수면 시간(sleep_hours)'의 교락
효과를 명시적으로 지적하였습니까?
NEXT CHAPTER PREVIEW
제2장. 실험 매트릭스와 참가자 설계
넷플릭스는 왜 A/B 테스트를 멈추지 않는가? 피험자 간 vs 피험자 내 설계의 비밀
➡️
PART 01 · FOUNDATION ARCHITECTURE · PAGE 15
15
[Chapter 01] Hypothesis Formulation & Variable Engineering — 4 Scales & Operational Definitions
CHAPTER 01
Hypothesis
Formulation
and
Variable
Specification
Transforming Everyday Curiosity into Sharp Data Benchmarks and Operational Definitions for
AI
[Figure 1-1] AI-Powered Scientific Research Odyssey: Even humble everyday curiosities evolve into
groundbreaking discoveries when calibrated with scientific benchmarks.
🎯 Chapter 1 Core Learning Objectives (High School to University Freshman Track)
Neutralizing AI Hallucinations: Discover why asking AI vague questions like "Is this app
good for students?" produces polite nonsense, and solve it with operational definitions.
The Black Swan & Detective's Logic: Scientific hypotheses do not assert "I am right"; they
operate like a court of law's presumption of innocence, seeking decisive counterexamples
(falsification).
The Frog Race & The 4 Scales of Measurement: The difference between 1st and 2nd place
could be 1 point or 50 points! Master why averaging ranks breaks downstream AI.
The Ice Cream Fallacy (Confounders): When ice cream sales and drowning rates spike
together, is ice cream the culprit? Unmask the real villain (summer heatwaves).
Golden Prompt 1-1 in Practice: Input everyday research questions to generate zero-defect,
machine-readable JSON protocols and synthetic datasets in seconds.
7
1.1 Why You Shouldn't Ask AI "Is This App Helpful for Studying?"
Imagine you and your friends spend a weekend coding a sleek smartphone app to help memorize
English vocabulary. Excited, you fire up ChatGPT or Claude and ask: "Hey, if students use this vocab
app, will it really help them study better?"
Within one second, the AI responds with glowing enthusiasm: "Absolutely! Utilizing mobile apps for
vocabulary acquisition enriches visual engagement, bolsters cognitive retention, and drives
remarkable academic achievement!" Can you present this response to your school teachers, parents,
or competition judges? Definitely not! This answer is not scientific evidence; it is merely polite,
articulate 'AI Hallucination' designed to flatter the user.
💡 Real-World Analogy: Why Mom's "Did You Study Hard Today?" Feels So Frustrating
Think about when your parents ask, "Did you study hard today?" The word 'hard' has no
universal meaning. Does sitting at your desk daydreaming for 3 hours count as 'hard', or does
solving 20 complex calculus problems count? When the benchmark is vague, meaningful
conversation breaks down.
Computers and AI function the exact same way. Large language models do not grasp
subjective, fuzzy human adjectives like 'helpful', 'improved focus', or 'game addiction'. Computers
are cold, arithmetic engines that calculate only 'quantifiable metric scales'.
Subjective Everyday Inquiries vs Quantifiable Operational Definitions
[Figure 1-2] Subjective Inquiries (Left) vs Quantifiable Operational Definitions (Right): Feeding
subjective adjectives to AI triggers hallucinations; feeding concrete metric benchmarks initiates precision data
science.
In scientific methodology, translating vague curiosity into a concrete measuring benchmark is
termed an 'Operational Definition'. The moment you replace "helps studying" with ➡️ "Students
using this app 20 minutes daily for 2 weeks will score on average >= 15 points higher on a
standardized 50-item vocabulary exam than students using paper flashcards", the AI stops making
things up and begins sharp statistical computation!
8
1.2 Falsificationism: Science Is Not About Clinging to Pet Theories!
For thousands of years, Europeans firmly believed an absolute truth: "All swans are white." Every
swan observed in lakes, rivers, and royal ponds across Europe had pristine white feathers. After
millions of sightings across centuries, this belief seemed untouchable.
Then, in 1697, Dutch explorer Willem de Vlamingh stepped onto the shores of Western Australia
and beheld an astonishing sight: a flock of majestic swans with feathers as black as charcoal! In a
single second, millions of confirming observations accumulated over millennia collapsed in front of
one single Black Swan.
Karl Popper, the foremost 20th-century philosopher of science, extracted a foundational principle
from this event: "Falsificationism". Genuine scientific hypotheses do not spend time frantically
hoarding evidence that screams "I'm right!"; instead, they must specify: "If my belief were wrong,
what concrete observation (a Black Swan) would prove it false?"
⚖️ Courtroom Logic: Presumption of Innocence and the Null Hypothesis (H₀)
A seasoned judge or detective never points at a suspect and shouts, "Guilty!" In a court of law,
trial proceedings begin with a cold baseline: "This individual is innocent until proven guilty
(Presumption of Innocence)." Only when undeniable video footage or DNA evidence (the Black
Swan) is presented can guilt be pronounced.
Statistics works identically! When setting up an experiment, researchers assume by default:
"My new app has zero effect (Effect = 0)." This skeptical baseline is called the Null Hypothesis
(H₀). We then collect empirical data and prove that the observed score gains are virtually
impossible by random luck alone, thereby rejecting the Null Hypothesis. Only then is our working
claim—the Alternative Hypothesis (H₁)—scientifically validated.
This rigor echoes Ronald Fisher's famous 1920s experiment, 'The Lady Tasting Tea'. When a
botanist claimed she could taste whether milk or brewed tea was poured first, Fisher did not dismiss
her. Instead, he presented 8 randomized cups in a blind tasting, calculated the exact probability of
guessing correctly by chance (
), and established whether her sensory claim was statistically
defensible.
H·
9
1.3 Numbers Aren't All Created Equal! Andy Field's 'Frog Race'
When working with spreadsheets or Python, beginner researchers often commit a fatal blunder:
"Seeing Arabic numerals on a screen and blindly calculating their arithmetic mean (Average)."
But numbers are not uniform; beneath the surface, they belong to four distinct hierarchical classes.
Psychologist Stanley Stevens formalized this as the '4 Levels of Measurement'.
[Figure 1-3] Understanding Measurement Scales via the Frog Race: Hoppy edges out Feebs by just 0.5
cm, yet Silas trails 42 cm behind. Intervals between ranks (Ordinal Scale) are never uniform!
World-renowned statistician Professor Andy Field illustrated this dilemma through the hilarious
parable of the 'Frog Race'. Three frogs (Hoppy, Feebs, and Silas) leap toward the finish line. Hoppy
crosses first, closely shadowed by Feebs just 0.5 cm behind in second place. Silas, however, gets
exhausted and crawls in third—a massive 42 cm back!
🏫 School Exam Ranks: The Trap of Ordinal Scales
Consider your high school midterm exam results. 1st place scored 99 points, and 2nd place
scored 98 points—a margin of just 1 point! Meanwhile, 3rd place scored 70 points—trailing 28
points behind!
Looking solely at ranks (1st, 2nd, 3rd), it appears the skill gap between everyone is an identical "1
rank". But the underlying knowledge gap is vastly uneven! If a teacher claims "The average rank of
our top three students is 2nd place", does that number tell you anything about their actual
mathematical competence? Absolutely not! This is why computing an arithmetic mean on ordinal
ranks produces meaningless nonsense.
Before prompting AI or statistical algorithms, we must explicitly declare whether a numeric variable
represents a raw rank, an arbitrary scale, or a physical quantity with a true absolute zero.
10
CORE SUMMARY
Stanley Stevens' 4 Measurement Scales at a Glance
Levels of Measurement
All numbers we encounter in daily life may look superficially identical in Arabic numerals, but their underlying
'mathematical permissions and computational rules' differ like night and day. Computers and generative AI cannot
intuitively discern whether a number denotes an athlete's jersey, a body temperature, or a race sprint time; they will
blindly add, average, and divide them regardless. Researchers must explicitly govern the fundamental scale nature of
each variable to prevent nonsensical statistical hallucinations.
Scale Type
Core Characteristic
Real-World Examples
Permitted Math
1. Nominal
(Categorical)
Pure
qualitative
labels
with
neither order nor size.
Mutually exclusive classification
only.
Jersey numbers (Son #7),
biological sex, blood types,
phone models
Counts (Frequency),
Mode
Addition & Mean
Prohibited
2. Ordinal
(Ranked)
Clear rank order, but the true
metric intervals between ranks
vary widely.
Race placements (1st, 2nd),
competitive
gaming
tiers,
movie star ratings
Median, Percentiles
Arithmetic Mean
Prohibited
3. Interval
(Equal Units)
Uniform
measurement
increments, but lacks a true
Absolute Zero.
Celsius (0°C is not absence of
heat), IQ scores, 5-point Likert
surveys
Addition,
Subtraction, Mean,
Standard Deviation
permitted
4. Ratio
(True Zero)
Possesses a true absolute zero;
ratio multiples (2x, 3x) hold
perfectly.
Reaction time (ms), body mass
(kg), height (cm), exam scores
All Arithmetic
Operations,
Geometric Mean, CV
🌡️ Expert Pro-Tip (Interval vs. Ratio Diagnostic): "If today is 10°C and tomorrow is 20°C, is tomorrow twice as hot as
today?" The answer is NO! Celsius 0°C is merely a human convention marking the freezing point of water, not the
absolute standstill of thermal kinetic energy (-273.15°C, or 0 Kelvin). By contrast, 180 cm is genuinely twice as tall as 90
cm, and 10 seconds is twice as fast as 20 seconds. Any scale anchored by the total absence of the measured property is
a gold-standard 'Ratio Scale'.
🎮 3-Second Real-World Scale Quiz for Gamers & Daily Life:
Q1. LoL competitive tiers (Bronze, Silver, Gold)? ➔ The skill gap between Bronze and Silver is vastly different from
Diamond to Master, making it an 'Ordinal Scale'!
Q2. Football jersey numbers (Son Heung-min #7)? ➔ Two #7 players on the pitch do not sum to a #14 player; it is
purely an identifier label, hence a 'Nominal Scale'!
Q3. Smartphone battery level (%)? ➔ 0% denotes the total absence of stored electrical charge (true absolute zero),
making it a 'Ratio Scale'!
1.4 Eating Ice Cream Causes Drowning? (The Logic of Causality)
In a renowned coastal resort town, researchers analyzing historical public safety statistics stumbled upon an alarming
phenomenon: "On days when beachfront ice cream parlor sales surged, accidental drowning incidents at the
beach skyrocketed in near-perfect lockstep!" The Pearson correlation coefficient reached a staggering r = 0.85.
Could eating sweet cold ice cream truly be the lethal cause of aquatic fatalities?
10
11
Behind both trends was a shared external engine: 'Scorching Summer Heatwaves', acting as a
potent Confounding Variable! When temperatures soar, people purchase more cold desserts;
simultaneously, far more people flock to the ocean to swim, inevitably driving up drownings.
[Figure 1-4] Spurious Correlation Between Ice Cream and Drowning: Behind the illusory direct cause-and-
effect relationship lurks a hidden confounding variable: summer heatwaves!
Philosopher John Stuart Mill formalized the 3 Essential Canons of Causality required to prove
that variable A truly causes outcome B:
1. Temporal Precedence: The cause (A) must precede the effect (B) in chronological time.
2. Co-variation: Whenever the cause changes, the outcome must systematically shift in tandem.
3. Elimination of Confounders: All plausible alternative explanations (sleep, intelligence,
environment) must be strictly isolated or statistically controlled!
1.5
Authoring
Machine-Readable
Variable
Protocols
with
Generative AI
Generative AI tends to equate co-variation with causality. Researchers must proactively command
AI: "Identify all hidden confounders in this domain and isolate them!" [Golden Prompt 1-1]
accomplishes this in seconds.
Golden Prompt 1-
1
Automated
Hypothesis
and
4-Variable
Protocol
Architect
Universal
LLM
Compatibility
[Instruction]: "Act as a world-class professor of statistical research methodology. For my research
inquiry: [Daily Short-form Video Exposure and Math Problem-Solving Focus Duration
in High School Students], formulate falsifiable Null (H₀) and Alternative (H₁) hypotheses, provide
operational definitions for Independent, Dependent, Control, and Confounding variables, and output a
standardized JSON data schema."
12
Machine-Readable JSON Research Schema & Variable Architecture
Executing Golden Prompt 1-1 returns a machine-readable JSON blueprint rather than unstructured
prose. This schema connects directly into Python Pandas or R pipelines for automated data
simulation in Chapter 3:
{ "research_question": "Impact of Daily Short-Form Video Consumption on Math
Focus Duration", "hypotheses": { "H0_null": "Daily short-form video watch time
has no statistically significant effect on continuous math focus duration (Effect
= 0).", "H1_alternative": "Students with longer daily short-form video watch time
exhibit significantly reduced continuous math focus duration." }, "variables": [
{ "name": "shorts_watch_time", "role": "Independent Variable (Cause)", "scale":
"Ratio Scale", "unit": "Minutes per day", "operational_definition": "Daily
average screen time logged on TikTok, Reels, and Shorts over 7 consecutive days"
}, { "name": "focus_duration", "role": "Dependent Variable (Outcome)", "scale":
"Ratio Scale", "unit": "Minutes", "operational_definition": "Continuous unbroken
immersion time solving college-entrance math questions before distraction" }, {
"name": "math_baseline_grade", "role": "Control Variable (Extraneous)", "scale":
"Ordinal Scale", "unit": "School Grade (1 to 9)", "operational_definition":
"Official overall math rank grade recorded in previous semester academic
transcripts" }, { "name": "sleep_hours", "role": "Confounder (Hidden Villain)",
"scale": "Ratio Scale", "unit": "Hours", "operational_definition": "Total sleep
duration recorded via wearable sleep tracker on the eve of the experimental
session" } ] }
🔍 Researcher's Architectural Takeaways:
1. hypotheses: Null (
) and Alternative (
) are explicitly paired, establishing the falsification game
rules.
2. scale: Metric levels (Ratio, Ordinal) prevent invalid statistical calculations like taking averages of ranks.
3. operational_definition: Concrete units (minutes, test duration) dismantle AI ambiguity and hallucinations.
4. sleep_hours: Identifies sleep duration as a key confounder to be statistically isolated in subsequent models.
H·
H·
13
1.6 AI Hands-on Workshop: Reader Lab Kit and Execution Guide
Congratulations! You have mastered the most formidable conceptual hurdle in statistical
methodology. Empirical inquiry succeeds not through rote mathematical memorization, but through
"falsifiable hypotheses, metric scale mastery, and confounder isolation". Let us put this into
practice using our 4-step hands-on workflow.
Download Lab Files
Chapter 1 Lab Kit
Reader Resource Drive (Open Access)
• 01_AI_Golden_Prompts_Library.md: Copy-and-paste prompt library
• 02_research_variable_schema.json: 4-variable machine-readable JSON
schema
• 03_sample_dataset_shorts_focus.csv: 50-student synthetic empirical
dataset
• 04_verify_data_and_scales.py: Python script for scale & correlation
verification
• 05_study_guide_and_quiz_solutions.md: In-depth conceptual guide &
solutions
🛠️
[4-Step Execution Blueprint] Follow These Steps Exactly:
Step 1 [Download Kit]: Scan the QR code or visit the link to download the 5 lab files into your local
project directory (e.g., stats_lab/).
Step 2 [AI Analysis]: Upload 03_sample_dataset_shorts_focus.csv to ChatGPT or Claude
and apply [Prompt 1-2: Scale Audit Prompt] from the prompt library to verify metric scales.
Step 3 [Execute Python Script]: Launch terminal, navigate to your directory, and run the
automated statistical validation script:
python3 04_verify_data_and_scales.py
Step 4 [Cross-Validation]: Compare Python terminal calculations with AI output using the 4-point
self-diagnosis checklist on the following page.
14
Verification Guide
Execution Output Cross-Validation & 4-Point Self-Diagnosis
"This is what success looks like." Compare your terminal calculations (top) with AI outputs (bottom) to
confirm all statistical figures match within normal tolerances.
[Figure 1-5] Lab Kit Execution Validation: (Top) Python Console / (Bottom) Generative AI Diagnostics
✅4-Point Self-Diagnosis Checklist
✓ [Check 1] 50 Observations & Zero Missing Values: Did the terminal confirm Sample Size:
50 | Missing: 0?
✓ [Check 2] Correct Scale Identifications: Did both Python and AI classify focus_duration and
shorts_watch_time as Ratio, and math_baseline_grade as Ordinal?
✓ [Check 3] Strong Negative Correlation: Did the terminal produce a significant negative
correlation of r = -0.8054, p < 0.001?
✓ [Check 4] Sleep Duration Confounder Audit: Did the AI explicitly caution that sleep_hours
must be isolated before claiming causality?
NEXT CHAPTER PREVIEW
Chapter 2: Experimental Matrices and Participant Design
Why Does Netflix Never Stop A/B Testing? Between-Subjects vs Within-Subjects Secrets
➡️
15