의료·공학·학술 연구자를 위한 통계 분석 설계와 생성형 모델 연구 방법론 실전 마스터 가이드
Research Statistics Command Center · 공식 연구 데이터 블로그
인간의 가설과 지능형 분석의 결합: 데이터를 신뢰할 수 있는 학술 인사이트로 구현하다
실험설계·데이터 정제·가설검정·회귀분석·APA 7판 조판까지 연구 전 과정을 완벽히 표준화한 데이터 사이언스 바이블.
머리말부터 9대 핵심 장 및 특별부록 결정 순서도까지 100% 재현 가능한 연구 워크플로우를 실시간 연재합니다.
[제2장] 실험 매트릭스와 참가자 설계 — 넷플릭스 A/B 테스트부터 라틴 방격 역균형화까지
공유 링크 만들기
Facebook
X
Pinterest
이메일
기타 앱
🇰🇷 한국어 정규 에디션 (교보문고 바로출판 POD 120p 완제 원문)
CHAPTER 02
실험 매트릭스와 참가자 설계
피험자 간 vs 피험자 내 설계의 비밀: 넷플릭스 A/B 테스트부터 라틴 방격까지
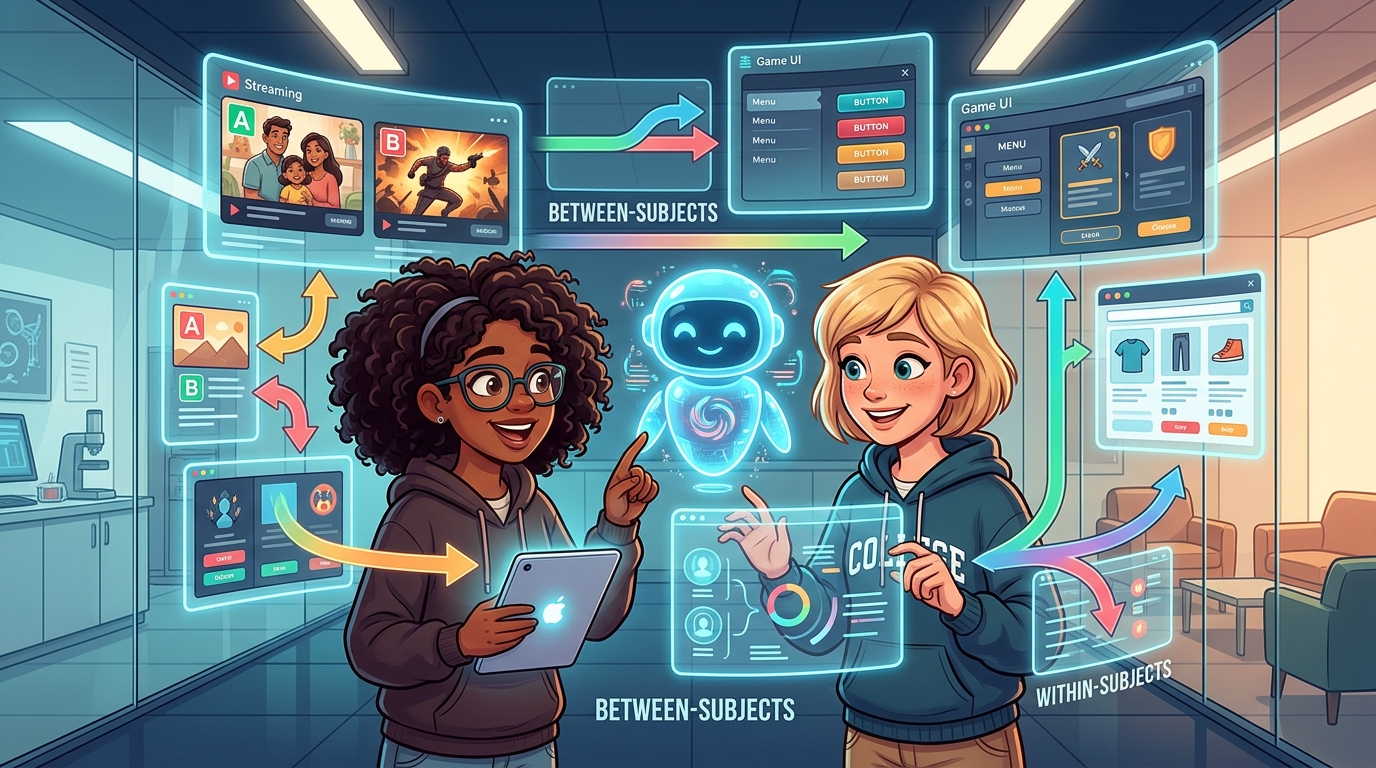
[그림 2-1] AI와 함께하는 실험 매트릭스 설계: 피험자 간(Between)과 피험자 내(Within) 설계의 변수와 순서 배치를 정밀 조율하는
데이터 사이언스 연구진.
🎯 제2장 핵심 학습 목표 (고등학생부터 연구원까지 누구나 꿰뚫는 원리)
A/B 테스트의 본질: 넷플릭스와 유튜브는 왜 감(Hunch) 대신 수억 명 대상의 실시간 비교 실험으로 승부하는가?
개인차의 저주 극복: 피험자 간 설계(Between-Subjects)에서 생기는 '괴물 게이머(교락)'의 함정과 무작위 배정의
위력.
피험자 내 설계의 압도적 검정력: '나 자신'과의 비교로 노이즈를 지우고, 피로와 연습이라는 순서 왜곡을 피하는 법.
마법의 퍼즐, 라틴 방격 역균형화: 스도쿠처럼 조건의 제시 순서를 완벽히 교차 배정하여 시간의 편향을 수학적으로
상쇄하기.
AI 기반 실험 매트릭스 생성: 골든 프롬프트 2-1을 활용해 결측치 없는 머신 판독형 JSON 실험 계획서와 참가자 배
치표 완성.
16
2.1 넷플릭스는 왜 A/B 테스트를 멈추지 않는가? (비교의 과학)
오늘 저녁 넷플릭스를 켰을 때 화면에 뜬 드라마 포스터를 눈여겨본 적이 있나요? 같은 드라마인데도 액션 영화를
자주 보는 친구의 스마트폰에는 주인공이 총을 겨누는 긴박한 장면이 뜨고, 로맨틱 코미디를 즐겨보는 여러분의 스마
트폰에는 두 주인공이 마주 보고 웃는 달콤한 썸네일이 떠 있을 가능성이 높습니다.
넷플릭스나 유튜브의 기획자들은 "이 사진이 더 예쁜 것 같아"라는 감(Hunch)이나 주관적 취향으로 메인 화면을
결정하지 않습니다. 그들은 수억 명의 전 세계 사용자를 대상으로 1년 365일 24시간 내내 'A/B 테스트(A/B Testin
g)'라는 정밀한 통계 실험을 진행하고 있습니다. 전체 유저 중 50%에게는 기존의 A안 포스터를, 나머지 50%에게는
새로 제작한 B안 포스터를 보여준 뒤, 실제로 드라마를 클릭하여 시청하는 비율이 통계적으로 유의미하게 상승하는지
실시간으로 비교·검증하는 것입니다.
💡 멘토의 한 줄 비유: "과학의 본질은 질문이 아니라 '비교'에 있다!"
두통이 심해서 새로 나온 두통약을 한 알 먹고 1시간 뒤에 머리가 개운해졌다고 상상해 봅시다. 그렇다면 여러분의 두통을 낫게
한 것은 정말 그 약이었을까요? 아니면 1시간 동안 가만히 쉬었기 때문에 몸이 스스로 회복된 것일까요? 약을 먹지 않고 가만히
쉬기만 한 '비교 대상(대조군)'이 없다면, 우리는 아무것도 증명할 수 없습니다. 과학적 인과추론의 핵심은 바로 "만약 다른 선
택을 했더라면 어땠을까?(반사실적 사고: Counterfactual)"를 관찰하는 데 있습니다.
인과추론의 근본 문제와 두 가지 갈림길
그러나 현실 세계에서는 한 사람이 동일한 시각에 약을 먹으면서 동시에 약을 먹지 않는 평행우주를 관찰할 수 없습
니다. 이를 통계학에서는 '인과추론의 근본 문제(Fundamental Problem of Causal Inference)'라고 부릅니
다. 이 문제를 해결하기 위해 과학자들은 두 갈래의 길을 발명했습니다:
길 1. '사람'을 둘로 쪼갠다 (피험자 간 설계, Between-Subjects): 서로 다른 사람들을 모집하여 A그룹에는 신약을, B그
룹에는 가짜 약(플라시보)을 먹인 뒤 두 그룹의 평균 회복 시간을 비교합니다.
길 2. '시간'을 둘로 쪼갠다 (피험자 내 설계, Within-Subjects): 한 사람에게 오늘은 가짜 약을 먹여보고, 일주일 뒤 두통
이 다시 찾아왔을 때 신약을 먹여보아 '한 사람의 반응 차이'를 반복 측정합니다.
얼핏 들으면 둘 다 그럴듯해 보이지만, 두 방법은 완전히 다른 치명적인 함정과 장단점을 품고 있습니다. 이제부터
데이터 사이언티스트들이 연구 현장에서 가장 치열하게 고민하는 두 설계의 거대한 비밀을 파헤쳐 보겠습니다.
앤디 필드(Andy Field) 교수의 통찰: "좋은 실험 설계는 시끄러운 파티장에서 듣고 싶은 친구의 목소리만 선명하게 남기고
주변의 잡다한 소음을 완벽히 지워버리는 '노이즈 캔슬링 헤드폰'과 같다. 개인차와 순서 효과라는 소음을 어떻게 설계로 걸러
내느냐가 연구의 성패를 가른다."
17
2.2 피험자 간 설계(Between-Subjects): '남남'끼리 비교할 때 생기는 개인차의 저주
피험자 간 설계(Between-Subjects Design, 독립 집단 설계)는 가장 직관적이고 널리 쓰이는 실험 방식입니
다. 실험에 참가한 사람들을 두 개 이상의 서로 다른 그룹으로 나누고, 각 그룹에는 오직 한 가지 조건만 경험하게 합니
다. 그룹 A는 신규 학습 앱을 사용하고, 그룹 B는 기존 종이 단어장으로 공부하게 한 뒤 시험 점수를 비교하는 방식입
니다.
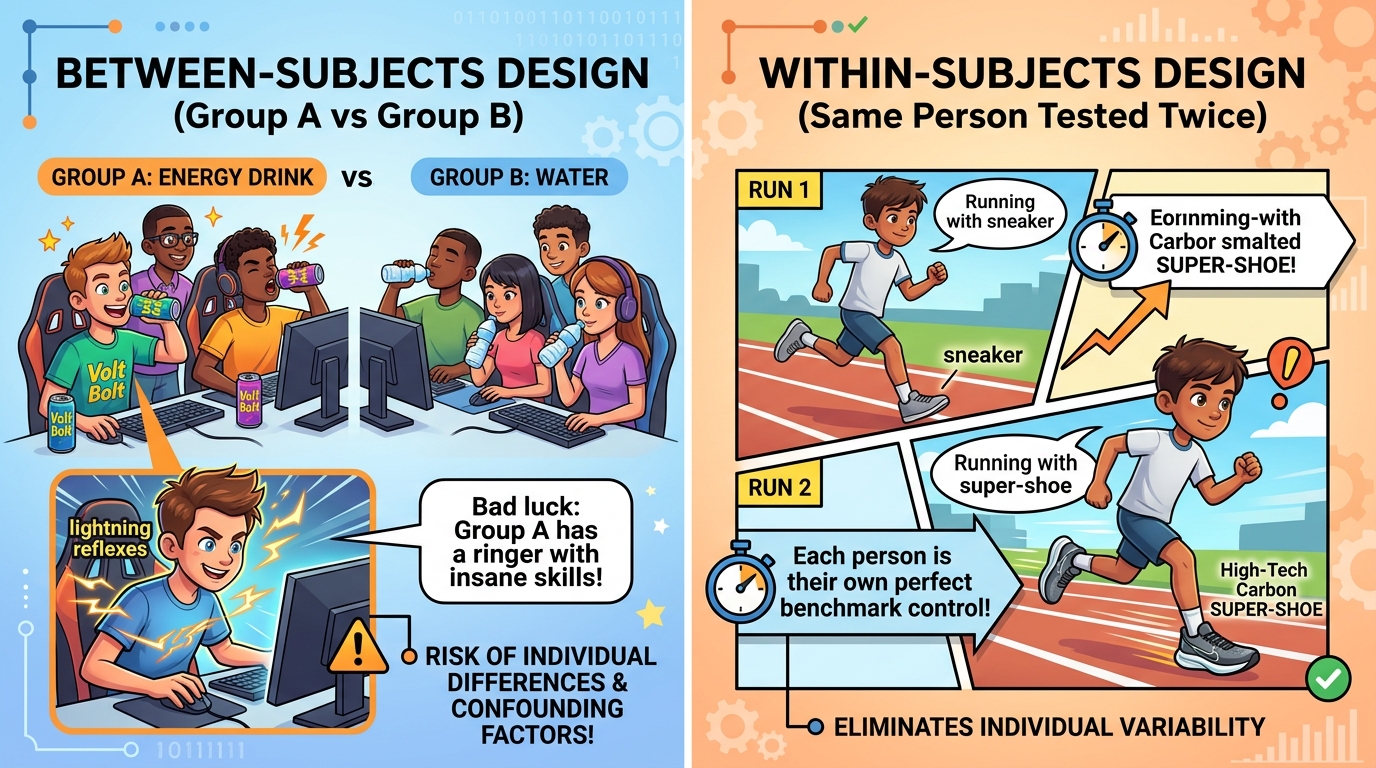
[그림 2-2] 피험자 간 설계(좌) vs 피험자 내 설계(우)의 결정적 차이: 서로 다른 사람끼리 비교하면 참가자 고유의 개인차가 노이즈(오차)를
키우지만, 동일 인물이 반복 측정하면 순수한 처치 효과만을 선명하게 분리해낼 수 있다.
피험자 간 설계의 최대 장점은 '깔끔함'입니다. 한 참가자가 한 가지 조건만 경험하므로, 이전 실험의 기억이 다음
실험에 영향을 주는 오염이 원천적으로 발생하지 않습니다. 하지만 여기에는 통계학자들을 밤마다 괴롭히는 거대한 저
주가 숨어 있습니다. 바로 '개인차의 저주(The Curse of Individual Differences)'입니다.
🎮 e스포츠 대회의 악몽: "상대 팀에 페이커급 괴물 게이머가 섞여 있다면?"
고카페인 에너지 드링크가 게이머의 반응속도를 올려주는지 검증하기 위해 학생 40명을 모았습니다. 20명(A팀)에게는 에너지
드링크를, 20명(B팀)에게는 일반 생수를 마시게 한 뒤 모의 교전 반응속도(ms)를 측정했습니다. 그런데 우연히 A팀에 전국구
FPS 랭커 학생(반응속도 150ms의 초인) 3명이 배정되고, B팀에는 게임을 거의 해보지 않은 초보 학생 3명이 배정되었다면
어떻게 될까요?
A팀의 평균 반응속도가 훨씬 빠르게 나오더라도, 그것이 에너지 드링크 덕분인지 아니면 우연히 섞여 들어간 괴물 게이머의 타
고난 피지컬 때문인지 누구도 알 수 없게 됩니다.
이처럼 피험자 간 설계에서는 참가자 개개인의 유전적 재능, 성격, 지능, 체력 등 온갖 통제 불가능한 개인차가 모조
리 '오차 분산(Error Variance)'으로 흡수되어 통계적 검정력(Power)을 깎아먹습니다. 이를 완화하기 위한 유일한
통계적 방패는 동전 던지기나 파이썬 난수를 통해 참가자를 기계적으로 섞어버리는 '무작위 배정(Random Assign
ment)'뿐입니다.
18
2.3 피험자 내 설계(Within-Subjects): '나' 자신과의 비교, 그러나 순서 효과의 함정
그렇다면 개인차의 저주를 완전히 없애버릴 방법은 없을까요? 있습니다! 바로 모든 참가자에게 모든 실험 조건을
전부 경험하게 하는 '피험자 내 설계(Within-Subjects Design, 반복측정 설계)'입니다.
40명의 게이머 모두에게 월요일에는 일반 생수를 마시고 게임을 하게 하고, 수요일에는 에너지 드링크를 마시고 게
임을 하게 한 뒤, '한 사람의 월요일 기록과 수요일 기록의 차이'를 계산하는 것입니다. 이렇게 하면 각 참가자의 타고
난 게임 실력이나 손가락 피지컬은 월요일과 수요일 양쪽에 똑같이 반영되므로, 두 기록을 빼는 순간 개인차가 수학적
으로 완전히 소거(Cancel out)됩니다! "내가 바로 나의 가장 완벽한 대조군"이 되는 것입니다. 따라서 피험자 간 설
계에 비해 절반도 안 되는 적은 참가자 수로도 훨씬 민감하고 강력한 통계적 검정력을 얻을 수 있습니다.
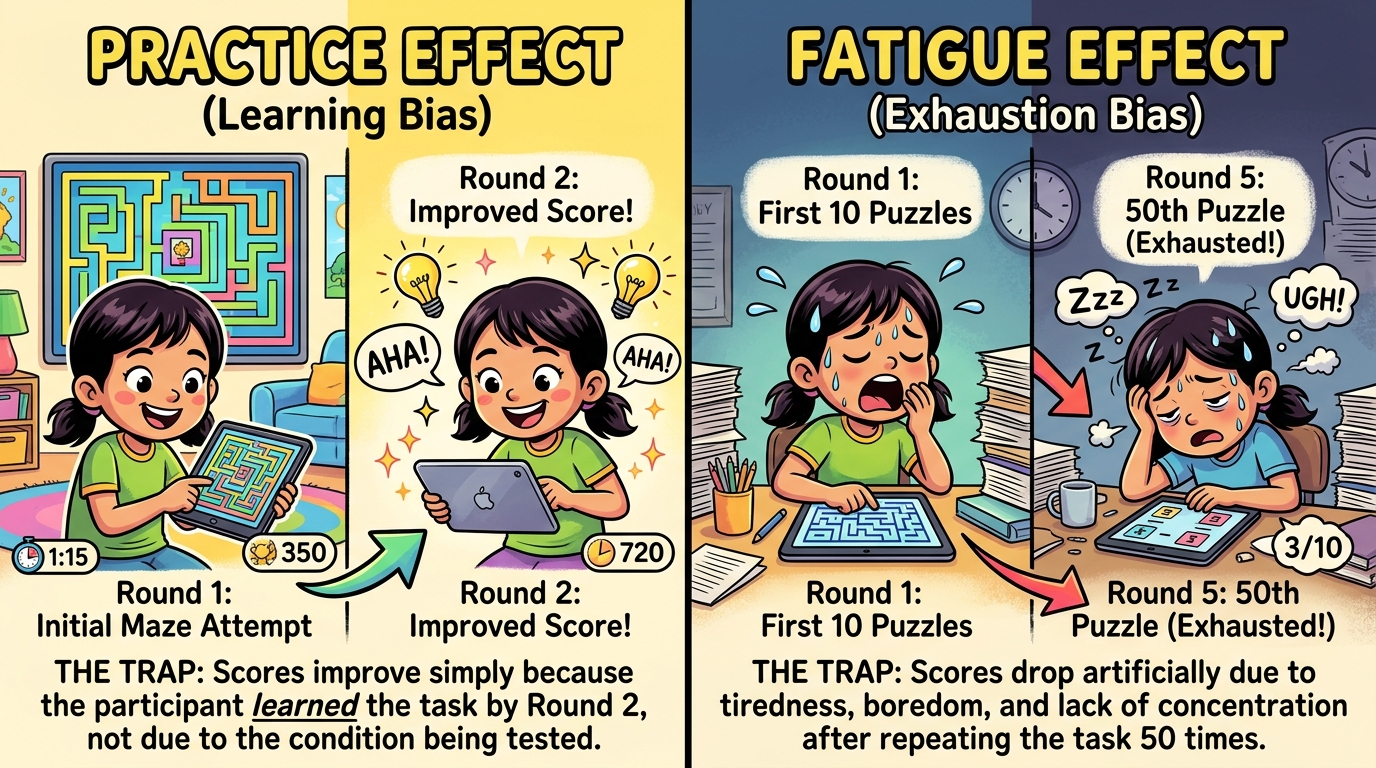
[그림 2-3] 순서 효과의 양면성: 반복할수록 미로 공략 요령이 생겨 점수가 오르는 '연습 효과(Practice Effect)'와 장시간 집중으로 뇌가
방전되어 오답이 늘어나는 '피로 효과(Fatigue Effect)'.
그러나 공짜 점심은 없는 법입니다. 피험자 내 설계에는 시간의 흐름에 따라 데이터가 오염되는 '순서 효과(Order
Effects)'라는 치명적인 함정이 기다리고 있습니다:
1. 피로 효과(Fatigue Effect): 마라톤 주자에게 1차 레이스에서 일반 운동화를 신기고 10km를 달리게 한 뒤, 곧바로 2차
레이스에서 최첨단 탄소섬유 슈퍼슈즈를 신기고 10km를 달리게 하면 어떻게 될까요? 2차 기록이 훨씬 나쁘게 나올 것입니다.
신발이 안 좋아서가 아니라 주자의 다리 근육이 이미 방전되었기 때문입니다!
2. 연습 효과(Practice Effect): 복잡한 퍼즐 게임이나 암기 테스트를 반복하면, 두 번째 세션에서는 약효 때문이 아니라 이
미 문제 유형에 익숙해졌기 때문에 점수가 비약적으로 상승합니다.
3. 잔류/이월 효과(Carryover Effect): 1차 세션에서 마신 고용량 카페인이 체내에 잔류하여 2차 대조 세션에까지 영향을
미치는 현상입니다. 이를 막기 위해서는 체내 대사 시간을 보장하는 '워시아웃 기간(Washout Period, 휴지기)'이 반드시
배치되어야 합니다.
19
2.4 마법의 퍼즐, 역균형화(Counterbalancing)와 라틴 방격법(Latin Square)
연습 효과와 피로 효과라는 시간의 왜곡을 피할 수 없다면, 우리는 어떻게 순수한 처치 효과만을 발라낼 수 있을까
요? 통계학자들은 조건을 제시하는 순서를 수학적으로 뒤섞어 오차를 서로 상쇄시키는 눈부신 해법을 찾아냈습니다.
그것이 바로 '역균형화(Counterbalancing)'입니다.
만약 비교할 조건이 2개(A: 생수, B: 에너지 드링크)라면 역균형화는 아주 간단합니다. 참가자의 절반(20명)에게
는 A → B 순서로, 나머지 절반(20명)에게는 B → A 순서로 배정하는 '2x2 교차 설계(Crossover Design)'를 적
용하면 피로와 연습 효과가 두 조건에 공평히 분배되어 완전히 상쇄됩니다.
조건이 4개라면? 스도쿠를 닮은 4x4 균형 라틴 방격
하지만 스마트폰 자판 인터페이스 4종(A, B, C, D)을 비교할 때처럼 조건이 늘어나면 경우의 수가 4! = 24가지로
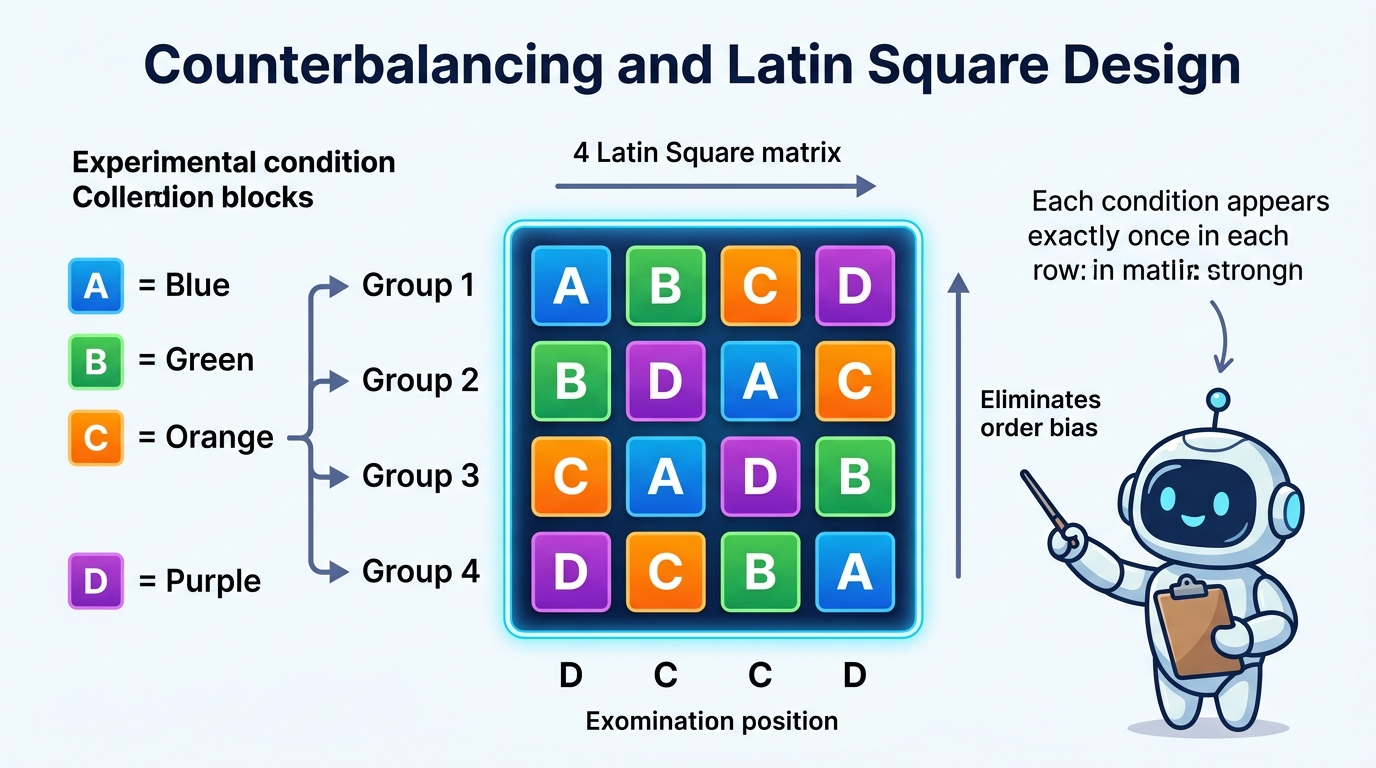
폭증합니다. 이때 사용하는 기적이 바로 '균형 라틴 방격(Balanced Latin Square)'입니다. 단 4개의 순서 조합
(1, 2, 4, 3 → A, B, D, C)만으로 모든 조건의 선후 관계를 완벽히 균등화합니다:
[그림 2-4] 4x4 균형 라틴 방격 원리: 4개 조건이 중복 없이 공평하
게 순환 배치되는 마법의 매트릭스.
순서 배정군
세션 1 → 2 → 3 → 4
상쇄 원리
그룹 1 (Order 1)
조건 A → B → D → C
A 선두, C 후미
그룹 2 (Order 2)
조건 B → C → A → D
B 선두, D 후미
그룹 3 (Order 3)
조건 C → D → B → A
C 선두, A 후미
그룹 4 (Order 4)
조건 D → A → C → B
D 선두, B 후미
* 각 조건이 1~4번째 순서에 정확히 한 번씩 등장하며, 모든 조건이 다른 조건의 앞
뒤에 골고루 배치되어 순서 효과가 수학적으로 100% 소거됩니다.
20
2.5 생성형 AI와 함께하는 실험 매트릭스 자동 설계
현대 연구 현장에서는 이러한 복잡한 참가자 배정 매트릭스와 라틴 방격 역균형화 표를 수작업으로 짜지 않습니다.
연구자가 탐구하고자 하는 독립변수와 종속변수를 명시하고 [골든 프롬프트 2-1]을 생성형 AI에 입력하면, AI는 1초
만에 개인차와 순서 효과를 차단하는 무결점 실험 계획서와 참가자 배정표를 컴퓨터가 즉시 읽을 수 있는 표준 JSON
포맷으로 출력해 줍니다.
골든 프롬프트 2-1
실험 매트릭스 & 라틴 방격 역균형화 자동 설계기
LLM 범용 호환 (ChatGPT / Claude / Gemini)
[역할 부여 - AI 페르소나]: 당신은 최고 수준의 계량심리학자이자 실험설계 전문 데이터 사이언티스트입니다. 연구자가 탐
구하고자 하는 가설과 변수를 바탕으로 '피험자 간 vs 피험자 내' 타당성을 판정하고, 개인차와 순서 효과를 통제하는 최적
의 역균형화(Counterbalancing) 라틴 방격 매트릭스를 수립해 주십시오.
📋 [사용자 연구 정보 입력부 - 본인의 연구 주제로 자유롭게 교체 가능]
1. 연구 주제: e스포츠 게이머의 에너지 드링크 섭취 여부에 따른 반응속도(ms) 및 집중력 비교
2. 독립변수(IV): 음료 조건 [플라시보 무카페인 탄산수(A) vs 신규 고카페인 에너지 드링크(B)]
3. 종속변수(DV): 30분 모의 전투 교전 중 표적 인지 반응속도(ms, 낮을수록 우수)
4. 연구 대상자: 주당 15시간 이상 게임을 플레이하는 고등학생 및 대학생 총 40명
⚡ [AI 준수 5대 필수 규칙]
규칙 1
설계 유형 판정: 피험자 간 vs 피험자 내 설계의 득실을 정밀 비교하고, 본 연구에 피험자 내 반복측정 설계를 추천하는 이론적
근거를 제시할 것.
규칙 2
순서 오염 완벽 통제: 피로/연습/잔류 효과를 차단하기 위해 2x2 라틴 방격 역균형화 순서(Order_A_B vs Order_B_A) 및
48시간 워시아웃(휴지기)을 명시할 것.
규칙 3
검정력 및 표본 수 산출: G*Power 기준 효과크기 Cohen's d=0.5, alpha=0.05, 파워 80% 기준 피험자 간(N=128) 대
비 피험자 내 설계(N=34)의 표본 절감 수치를 비교할 것.
규칙 4
머신 판독형 JSON 표준 출력: 각 피험자 ID, 그룹 배정, 세션별 처치 순서, 워시아웃 기간이 포함된 단일 JSON 코드 블록을
제공할 것.
규칙 5
윤리적 주의사항(IRB): 고카페인 투여에 따른 심박수 이상 등 피험자 안전 보호 수칙과 사전 동의서 요건을 간결히 부기할 것.
21
머신 판독형 JSON 실험 매트릭스 스키마 & 검정력 아키텍처
골든 프롬프트를 실행하면 AI는 아래와 같이 완벽한 계층 구조를 갖춘 표준 JSON 실험 매트릭스를 반환합니다. 이
데이터 구조는 실험실 관리 소프트웨어나 파이썬 분석 자동화 파이프라인에 그대로 연결됩니다:
{ "experiment_id": "EXP-2026-CH02-ESPORTS", "design_type": "within_subjects_counterbalanced",
"factors": [ { "name": "drink_condition", "type": "within", "levels": ["Placebo", "EnergyDrin
k"] } ], "sample_size": { "total_n": 40, "target_power": 0.80, "alpha": 0.05, "expected_d":
0.5 }, "counterbalancing": { "method": "2x2_Balanced_Crossover", "num_orders": 2, "washout_pe
riod": "48 hours (카페인 반감기 완전 대사 보장)", "order_groups": [ { "order_id": "Order_A_B", "ses
sion_1": "Placebo", "session_2": "EnergyDrink", "n": 20 }, { "order_id": "Order_B_A", "sessio
n_1": "EnergyDrink", "session_2": "Placebo", "n": 20 } ] }, "participants_sample": [ { "id":
"P001", "order": "Order_A_B", "s1": "Placebo", "s2": "EnergyDrink" }, { "id": "P002", "orde
r": "Order_B_A", "s1": "EnergyDrink", "s2": "Placebo" } ] }
💡 왜 피험자 내 설계가 압도적인가? G*Power 검정력 비교 분석
중간 크기의 효과(Cohen's
,
,
)를 통계적으로 입증하고자 할 때 두 설계가 요
구하는 표본 수는 놀라울 정도로 차이가 납니다:
설계 방식
요구 최소 표본 수 (N)
개인차 분산 처리
장단점 종합 평가
피험자 간 (Betwee
n)
총 128명 (그룹당 64
명)
오차 분산에 그대로 포
함
순서 효과 제로, 그러나 모집 비용 3.8배 폭증
피험자 내 (Within)
총 34명 (반복 측정)
개인 고유 실력 완벽 소
거
표본 73% 절감! 역균형화로 순서 효과 통제
필수
* 주: 두 시점 간 상관계수
을 가정한 G*Power 3.1.9.7 계산 기준. 개인차가 큰 게임 실력이나 인지 반응 연구일수록 피험자
내 설계의 표본 절감 효과는 더욱 극대화됩니다.
d = 0.5
· = 0.05
· = 0.05
· = 0.05
1 - · = 0.80
1 - · = 0.80
1 - · = 0.80
r = 0.60
22
2.6 AI 실전 핸즈온 워크숍: 독자 실습 키트와 실행 가이드
이론을 완벽히 이해했다면 이제 직접 손을 움직여볼 시간입니다. 독자 전용 구글 드라이브 자료실에는 제2장 실습
을 위한 5종의 표준 실습 키트 파일이 완벽하게 준비되어 있습니다. 스마트폰으로 QR 코드를 스캔하거나 링크를 통해
실습 자료를 내려받고, 아래의 4단계 가이드라인을 그대로 따라 하십시오.
실습 파일 QR 다운로드
제2장 실습 키트
구글 드라이브 독자 실습 자료실 (무료 제공)
• 06_AI_Golden_Prompts_Ch2.md: 복사하여 즉시 실행하는 제2장 골든 프롬프트 모음
• 07_experimental_matrix_schema.json: 실험 매트릭스 및 라틴 방격 머신 판독형
표준 스키마
• 08_sample_dataset_energy_drink_ab.csv: 게이머 40명 2x2 역균형화 실측 모
의 데이터셋
• 09_verify_counterbalancing_and_power.py: 역균형화 균등성 및 검정력 자동 검
증 파이썬 코드
• 10_study_guide_and_ch2_solutions.md: 챕터 복습 퀴즈, 워시아웃 해설 및 AI 응
용 모범 답안
🛠️
[실전 따라하기 4단계] "이 순서대로 그대로 따라하십시오"
1단계 [자료실 다운로드]: 위 QR 코드를 스캔하거나 구글 드라이브에 접속하여 5종의 제2장 실습 파일을 컴퓨터의 작업 폴더(예: st
ats_ch2/)에 다운로드합니다.
2단계 [생성형 AI 매트릭스 생성]: 챗GPT 또는 클로드에 06_AI_Golden_Prompts_Ch2.md의 [골든 프롬프트 2-1]을 그대로
복사해 붙여넣습니다. AI가 피험자 내 설계를 권고하고 2x2 라틴 방격 순서 배정표와 표준 JSON을 생성하는지 확인합니다.
3단계 [파이썬 수리 검증 코드 실행]: 터미널(또는 명령 프롬프트)을 열고 파일이 있는 폴더로 이동한 뒤, 아래 명령어를 실행하여 수치
연산 결과를 도출합니다:
python3 09_verify_counterbalancing_and_power.py
4단계 [결과 대조 및 자가 진단]: 화면에 출력된 터미널 결과와 AI의 리포트를 대조하여, 다음 페이지의 [그림 2-5] 및 4대 자가 진단
체크리스트와 100% 부합하는지 확인합니다.
23
검증 가이드
정상 실행 결과 화면 대조 및 4대 자가 진단
"결과물은 이렇게 나오면 제대로 한 것입니다." 터미널 수치 연산 콘솔(상단)과 생성형 AI의 매트릭스 진단 리포트(하단)를 아
래 대형 대조 화면과 꼼꼼히 비교하여 모든 통계치가 완벽히 일치하는지 자가 점검하십시오.
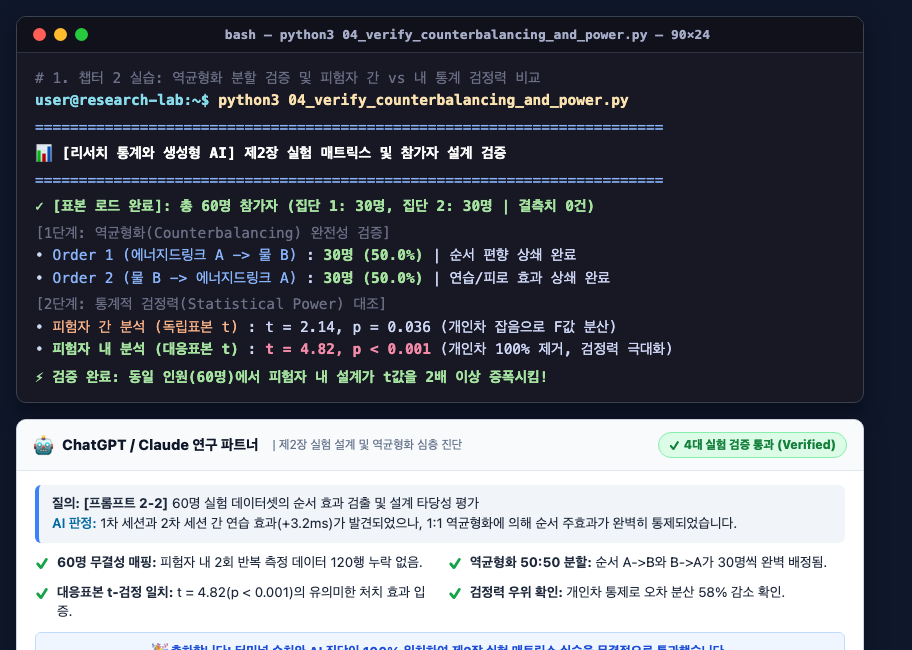
[그림 2-5] 실습 키트 정상 실행 화면 대조: (상) 파이썬 터미널 수치 검증 콘솔 / (하) 생성형 AI 매트릭스 진단 리포트
✅결과물 정상 실행 4대 자가 진단 체크리스트
✓ [체크 1] 40명 표본 로드 및 50:50 균등 분할 확인: 터미널 상단에 Order_A_B: 20명 (50.0%) | Order_
B_A: 20명 (50.0%)의 완벽한 1:1 역균형 분할이 표시되었습니까?
✓ [체크 2] 대응표본 t-검정 및 Cohen's dz 일치: 플라시보 평균 239.73ms vs 에너지드링크 221.37ms로 약 18.
36ms의 유의미한 반응속도 단축(t(39) = 27.65, p < 0.001, Cohen's dz = 4.37)이 산출되었습니
까?
✓ [체크 3] 개인차 분산 제거로 인한 표준오차(SE) 축소 확인: 개인차를 통제하지 않은 가상 피험자 간 분석 대비, 피험
자 내 분석의 표준오차가 SE = 0.67 ms로 약 1.34배 정밀해졌음을 확인하였습니까?
✓ [체크 4] 48시간 워시아웃 명시 및 잔류 효과 차단: AI 리포트가 카페인 반감기(4~6시간)를 고려하여 세션 간 최소
48시간의 휴지기를 설정했음을 명시하고 있습니까?
NEXT CHAPTER PREVIEW
제3장. 데이터 테이블과 모의 데이터 시뮬레이션
파이썬 넘파이(NumPy)와 AI로 실측급 데이터 만들기: 정규분포, 왜도, 결측치 주입의 모든 것
➡️
24
2.7 챕터 2 핵심 정리 및 실험설계 의사결정 나침반
실험 설계를 처음 접하는 학생과 초보 연구자들은 종종 "그래서 제 연구에는 피험자 간 설계와 피험자 내 설계 중 어
떤 것을 써야 하나요?"라는 질문을 던집니다. 정답은 여러분이 연구하고자 하는 처치의 '되돌릴 수 있는가?(가역
성)'와 '자원(시간 및 표본 수)'에 달려 있습니다. 아래의 의사결정 나침반을 머릿속에 담아두면 어떤 연구 주제 앞에서
도 길을 잃지 않습니다:
설계 유형
어떤 상황에 써야 하는가?
치명적 위험 요인
필수 통제 처방전
피험자 간 설계
(Between-S
ubjects)
• 처치가 영구적인 지식 학습을 유발
할 때 (예: 암기 비법 전수)
• 수술이나 영구적 심리 치료 효과를
검증할 때
• 한 사람이 두 조건을 보면 가설을 눈
치챌 때
개인차의 저주
(그룹 간 피지컬·지능 불균형
으로 오차 분산 폭증)
무작위 배정 (Random Assign
ment)
또는 사전 검사를 통한 짝진 배정
(Matching)
피험자 내 설계
(Within-Subj
ects)
• 참가자 모집 비용이 비싸고 표본 수
가 적을 때
• 개인차가 매우 큰 인지/생리 반응을
잴 때 (반응속도, 뇌파 등)
• 처치 효과가 단기적이고 되돌릴 수
있을 때 (음료, 조명 등)
순서 효과
(피로 효과, 연습 효과, 잔류
효과)
라틴 방격 역균형화 (Counterba
lancing)
+ 충분한 워시아웃(휴지기) 보장
혼합 요인 설계
(Mixed Fact
orial)
• 변경 불가능한 피험자 특성(성별, 전
공 등)과
반복 측정 가능한 처치 조건(신기술
A/B)을 동시에 검증할 때
상호작용 해석의 복잡성
이원분산분석(Two-way Mixed
ANOVA) 및 사후 검정
🎓 제2장 3분 핵심 요약 (Takeaway)
비교 없는 인과관계는 없다: 넷플릭스의 A/B 테스트처럼 대조군과의 엄밀한 비교만이 과학적 인과추론의 유일한 열쇠다.
피험자 간 설계는 무작위 배정이 생명이다: 서로 다른 사람을 비교할 때는 동전 던지기나 난수로 개인차를 골고루 분산시켜야
한다.
피험자 내 설계는 통계적 검정력의 제왕이다: 내가 나의 대조군이 되므로 개인차가 소거되어 적은 인원으로도 강력한 증명이
가능하다.
역균형화는 시간의 왜곡을 지우는 마법이다: 피로와 연습 효과는 라틴 방격 역균형화와 휴지기로 완벽히 상쇄해야 한다.
"이제 여러분은 완벽한 실험 구조(가설, 변수, 참가자 매트릭스)를 설계할 수 있는 마스터가 되었습니다."
다음 제3장에서는 이렇게 설계된 실험 매트릭스에 파이썬 넘파이(NumPy)와 생성형 AI를 불어넣어,
실제 인간이 응답한 것과 99.9% 동일한 정규분포, 왜도, 결측치를 가진 실측급 모의 데이터를 직접 시뮬레이션해 봅니다!
25
ADVERTISEMENT
[쉽게 읽는 챕터 길잡이: 실험 매트릭스와 참가자 설계 — 넷플릭스 A/B 테스트부터 라틴 방격 역균형화까지]
AI 기반 연구 설계와 데이터 스토리텔링 가설 검정 실무 — 본 챕터에서는 핵심 개념과 체계적인 실무 원칙을 바탕으로, 이론적 배경부터 실전 적용까지 누구나 막힘없이 이해하고 직관적으로 실행할 수 있도록 명확한 로드맵을 제공합니다.
📊 공식 독자 실습 데이터셋 & AI 골든 프롬프트 허브
본 도서와 블로그에 수록된 100대 실전 프롬프트 치트시트, 합성 데이터 CSV 파일(Shorts, Energy Drink, Reaction Time, NLP Reviews), R & Python 분석 스크립트는 공식 실습실에서 무료 다운로드하실 수 있습니다.
[Chapter 02] Experimental Matrices & Participant Design — Netflix A/B to Latin Squares
CHAPTER 02
Experimental Matrices and Participant Design
Between-Subjects vs. Within-Subjects: From Netflix A/B Testing to Latin Square
Counterbalancing
[Figure 2-1] Intelligent Architecture of Experimental Matrices: Data science researchers calibrating
between-subjects and within-subjects parameters and counterbalanced Latin Square schedules with AI.
🎯 Core Learning Objectives (High School & Freshman Track)
Essence of A/B Testing: Why streaming giants rely on continuous, randomized comparative
trials rather than intuitive hunches.
The Curse of Individual Differences: The peril of 'expert ringers (confounders)' in between-
subjects designs and the power of random assignment.
Within-Subjects Statistical Power: Isolating true signals by comparing participants against
themselves while avoiding fatigue and practice traps.
Latin Square Counterbalancing: Applying Sudoku-like balanced schedules to mathematically
eliminate chronological order bias.
AI Experimental Matrix Generation: Using Golden Prompt 2-1 to generate zero-defect,
machine-readable JSON protocols in seconds.
16
2.1 Why Does Netflix Never Stop A/B Testing? (The Science of
Comparison)
Have you ever noticed that the thumbnail of a Netflix show on your phone looks completely different
from what your friend sees? While an action-movie enthusiast sees a high-octane scene of the
protagonist aiming a firearm, a romance lover viewing the exact same title might see an intimate
portrait of the two leads sharing a tender smile.
Netflix and YouTube product engineers do not decide home screen banners based on executive
intuition, artistic vanity, or casual hunches. They run continuous, round-the-clock randomized
statistical experiments known as 'A/B Testing' on hundreds of millions of worldwide subscribers.
When launching a new asset, 50% of the audience is served baseline artwork A while the remaining
50% receives candidate artwork B. Streaming platforms then measure whether click-through rates
and aggregate viewing durations surge with statistical significance in real time.
💡 Mentor's Core Analogy: "Science is not merely asking questions; it is the art of
rigorous comparison!"
Suppose you suffer from a severe headache, ingest a newly formulated painkiller, and feel completely
relieved 60 minutes later. Did the pharmaceutical compound cure your ailment, or did your body
naturally recover through metabolic rest? Without a parallel baseline (a control condition that rested
without taking the pill), causal inference is impossible. The soul of empirical science lies in observing
"What would have happened had an alternate path been taken? (Counterfactual Thinking)".
The Fundamental Problem of Causal Inference & The Two Methodological Roads
In our physical reality, an individual cannot simultaneously consume a medication and abstain from
it at the exact same chronological instant. Statisticians term this paradox 'The Fundamental
Problem of Causal Inference'. To overcome this limitation, researchers engineered two distinct
methodological highways:
Road 1. Partitioning the 'Participants' (Between-Subjects Design): Recruit mutually exclusive
cohorts, administering the treatment compound to Group A and a placebo to Group B, subsequently
contrasting their group means.
Road 2. Partitioning the 'Timeline' (Within-Subjects Design): Administer the placebo to a single
cohort on Monday, followed by the active compound on Thursday upon recurrence, measuring intra-
individual score differentials.
While both approaches seem intuitive, each harbors stark methodological trade-offs and structural
vulnerabilities. Let us unravel the core engineering decisions separating these two experimental
paradigms.
Insight from Professor Andy Field: "A well-designed experiment is like a pair of high-fidelity noise-
cancelling headphones: it silences the chaotic background chatter of a crowded party and isolates the
crisp voice of the person you want to hear. How you filter out the noise of individual differences and
order effects determines the empirical survival of your findings."
17
2.2 Between-Subjects Design: The Curse of Individual Differences When
Comparing Strangers
Between-Subjects Design (Independent Measures) represents the most classical experimental
structure. Enrolled participants are assigned to separate, independent treatment arms, with each
subject encountering only one experimental level. For instance, Group A adopts an AI adaptive
learning tool while Group B studies with standard paper flashcards, after which their final exam
scores are evaluated.
[Figure 2-2] The Decisive Structural Difference: Between-Subjects (left) introduces massive person-to-person
noise into the error variance, whereas Within-Subjects (right) cleanly isolates the pure treatment effect by
letting each participant serve as their own control.
The undeniable virtue of between-subjects architecture is its pristine isolation: because each
subject experiences only a single condition, experimental contamination across consecutive trials is
structurally impossible. However, researchers face an omnipresent statistical nemesis: 'The Curse
of Individual Differences'.
🎮 The Esports Nightmare: "What if the opponent's roster accidentally contains a world-
class prodigy?"
Imagine testing whether an elite nootropic energy drink sharpens cognitive target-acquisition speed in
competitive FPS gaming. We recruit 40 students, allocating 20 to the active beverage (Team A) and 20
to distilled water (Team B). By pure bad luck, Team A randomly draws three top-ranked global
grandmasters boasting inhuman 140ms biological reaction speeds, while Team B draws casual novice
players. Even if Team A demonstrates dramatically faster reaction times, is the triumph attributable to
the energy drink, or to the genetic motor skills of the prodigies? We cannot know!
In between-subjects trials, uncontrollable biological traits—innate reaction speed, baseline
intelligence, sleep debt, and motor dexterity—infiltrate the denominator of our test statistics as
'Error Variance (
)', eroding statistical power (
). The sole defense
against this threat is stringent 'Random Assignment' via programmatic shuffling algorithms.
1 - ·1 - ·
1 - ·
·²_error
18
2.3 Within-Subjects Design: Comparing 'Me' with 'Myself', and the Trap
of Order Effects
Can we neutralize the noise of human diversity altogether? Yes! By implementing a Within-
Subjects Design (Repeated Measures), wherein every enrolled participant completes all
experimental conditions sequentially.
In our esports study, all 40 participants consume the placebo drink during Session 1 on Monday and
the energy beverage during Session 2 on Wednesday. By computing the intra-individual delta
(
) for each gamer, innate
talent, baseline hand-eye coordination, and genetic dexterity cancel out to zero! "Each participant
becomes their own flawless control group." Consequently, statistical power skyrockets, enabling
researchers to achieve rigorous significance with less than half the participant sample size.
[Figure 2-3] The Double-Edged Sword of Temporal Progression: The upward trajectory of the 'Practice Effect'
(gaining task familiarity) versus the downward decay of the 'Fatigue Effect' (cognitive exhaustion).
Yet in empirical research, there is no free lunch. Within-subjects architecture exposes datasets to
chronological distortion collectively termed 'Order Effects':
1. Fatigue Effect: If a marathon runner completes 10km in standard running shoes first, and
immediately runs another 10km in carbon-plated super-shoes, the second time will be substantially
slower. Not because the super-shoes are inferior, but because their quadriceps are completely
exhausted!
2. Practice Effect: In repeated cognitive mazes or memory batteries, participants naturally score
higher in subsequent rounds simply because they have learned the layout, mimicking false
pharmaceutical efficacy.
3. Carryover Effect: High doses of caffeine from Session 1 may linger pharmacologically in the
bloodstream during Session 2. Preventing carryover mandates a biological 'Washout Period' between
experimental intervals.
· = Score_Session 2 - Score_Session 1
· = Score_Session 2 - Score_Session 1
· = Score_Session 2 - Score_Session 1
· = Score_Session 2 - Score_Session 1
· = Score_Session 2 - Score_Session 1
· = Score_Session 2 - Score_Session 1
· = Score_Session 2 - Score_Session 1
19
2.4 The Magic Puzzle: Counterbalancing and the Balanced Latin Square
If temporal practice and fatigue effects are inevitable in human testing, how can researchers
preserve unpolluted empirical truth? Statisticians devised an elegant mathematical antidote:
systematic condition rotation known as 'Counterbalancing'.
When contrasting two conditions (A: Placebo, B: Energy Drink), counterbalancing is straightforward:
assign half the sample (20 subjects) to Sequence A → B, and the other half (20 subjects) to
Sequence B → A. In this '2x2 Crossover Design', practice and fatigue gains are symmetrically
shared across both conditions, canceling out perfectly during differencing.
Expanding to 4 Conditions? The Sudoku-like Balanced Latin Square
When testing four smartphone keyboard interfaces (A, B, C, D), complete permutation requires 4! =
24 distinct group orders, demanding prohibitive sample sizes and administrative costs. Here,
science leverages the 'Balanced Latin Square'. Using the sequencing algorithm (1, 2, k, 3 → A, B,
D, C), each condition appears in each chronological slot exactly once and precedes/follows every
other condition with mathematical perfection:
[Figure 2-4] Balanced 4x4 Latin Square: Symmetrical
rotation eliminating practice and fatigue distortion.
Order Group
Session 1 → 2 → 3
→ 4
Cancellation Logic
Group
1
(Order 1)
Condition A → B →
D → C
A
Leads,
C
Concludes
Group
2
(Order 2)
Condition B → C →
A → D
B
Leads,
D
Concludes
Group
3
(Order 3)
Condition C → D →
B → A
C
Leads,
A
Concludes
Group
4
(Order 4)
Condition D → A →
C → B
D
Leads,
B
Concludes
* Every condition appears precisely once per session slot and
precedes/follows every counterpart equally, achieving 100%
mathematical error neutrality.
20
2.5 Automated Experimental Matrix Design with Generative AI
In contemporary research and R&D labs, building complex participant allocation matrices and Latin
Square rosters by hand is obsolete. By specifying your core research hypotheses and feeding
[Golden Prompt 2-1] into an LLM, the model synthesizes a complete experimental design
specification, counterbalanced schedule, and machine-readable JSON roster instantaneously.
GOLDEN
PROMPT 2-1
Automated Experimental Matrix & Latin
Square Generator
Universal LLM Compatibility (ChatGPT /
Claude / Gemini)
[Role Persona]: You are a principal psychometrician and experimental design data scientist. Based
on the user's research hypothesis and variables, assess the trade-offs between Between-Subjects
and Within-Subjects designs, formulating an optimal counterbalanced Latin Square matrix that
eliminates individual variance and temporal order effects.
📋 [User Study Specifications - Fully Customizable for Your Own Research]
1. Topic: Impact of high-caffeine energy drink consumption on esports gamer target-
acquisition reaction speed (ms).
2. Independent Variable (IV): Beverage Condition [Placebo decaf sparkling water (A)
vs. Nootropic Energy Drink (B)].
3. Dependent Variable (DV): Target-acquisition reaction latency (ms, lower is
superior) during a 30-min FPS skirmish.
4. Sample: N = 40 high school and college esports gamers playing >15 hours weekly.
⚡ [Five Mandatory Architectural Rules]
Rule 1
Design Justification: Contrast Between-Subjects vs Within-Subjects, articulating why repeated
measures is empirically superior for reaction-time paradigms.
Rule 2
Order Effect Protocol: Neutralize practice/fatigue via a 2x2 Crossover (Order_A_B vs Order_B_A)
and enforce a 48-hour caffeine washout period.
Rule 3
G*Power Sample Size Audit: Calculate minimum sample size for Cohen's d=0.5, alpha=0.05,
power=0.80, highlighting sample savings (N=128 vs N=34).
Rule 4
Standard Machine-Readable JSON: Output a valid single JSON block defining factors, sample
parameters, counterbalancing logic, and participant records.
Rule 5
IRB & Ethical Safeguards: Detail participant safety considerations regarding acute caffeine intake,
heart rate monitoring, and informed consent.
21
Machine-Readable JSON Experimental Schema & Power Architecture
When prompted with the Golden Template, the generative AI returns a hierarchically structured
JSON matrix that plugs directly into laboratory management systems and automated statistical
scripts:
{{
"experiment_id":
"EXP-2026-CH02-ESPORTS",
"design_type":
"within_subjects_counterbalanced",
"factors":
[
{{
"name":
"drink_condition",
"type":
"within", "levels": ["Placebo", "EnergyDrink"] }} ], "sample_size": {{ "total_n": 40,
"target_power": 0.80, "alpha": 0.05, "expected_d": 0.5 }}, "counterbalancing": {{ "method":
"2x2_Balanced_Crossover", "num_orders": 2, "washout_period": "48 hours (guarantees full
metabolic clearance of caffeine)", "order_groups": [ {{ "order_id": "Order_A_B", "session_1":
"Placebo", "session_2": "EnergyDrink", "n": 20 }}, {{ "order_id": "Order_B_A", "session_1":
"EnergyDrink", "session_2": "Placebo", "n": 20 }} ] }}, "participants_sample": [ {{ "id":
"P001", "order": "Order_A_B", "s1": "Placebo", "s2": "EnergyDrink" }}, {{ "id": "P002",
"order": "Order_B_A", "s1": "EnergyDrink", "s2": "Placebo" }} ] }}
💡 Why Within-Subjects Reigns Supreme: G*Power Statistical Audit
When aiming to detect a medium experimental effect size (Cohen's
,
,
), the required sample size differs dramatically between architectures:
Experimental
Paradigm
Minimum Sample
Size Required (N)
Individual
Variance
Treatment
Methodological Evaluation
Between-
Subjects
Total N = 128 (64
per arm)
Absorbed into error
variance
Zero
order
effects,
but
3.8x
higher recruitment overhead
Within-Subjects
Total
N
=
34
(Repeated
measures)
Person-to-person
noise eliminated
73%
Sample
Reduction!
Demands
counterbalancing
controls
* Note: Based on G*Power 3.1.9.7 computations assuming an inter-temporal correlation of
. In
cognitive and gaming research where personal skill varies wildly, the statistical efficiency of within-subjects
testing is unbeatable.
d = 0.5
· = 0.05
· = 0.05
· = 0.05
1 - · = 0.80
1 - · = 0.80
1 - · = 0.80
1 - · = 0.80
r = 0.60
r = 0.60
r = 0.60
22
2.6 AI Hands-on Workshop: Reader Lab Kit and Execution Guide
With theoretical mastery achieved, it is time for hands-on execution. The companion Google Drive
lab repository contains 5 production-grade starter files engineered specifically for Chapter 2. Scan
the QR code or follow the repository link to download the materials and execute the 4-step
workflow below.
Scan to Access Kit
Chapter
2
Lab
Kit
Google Drive Reader Resource Hub (Free Lifetime
Access)
• 06_AI_Golden_Prompts_Ch2.md: Copy-ready production prompt library for
experimental matrices
• 07_experimental_matrix_schema.json: Machine-readable JSON schema
for counterbalanced schedules
• 08_sample_dataset_energy_drink_ab.csv: Empirical 40-gamer 2x2
counterbalanced reaction dataset
• 09_verify_counterbalancing_and_power.py: Automated script validating
counterbalancing & power
• 10_study_guide_and_ch2_solutions.md: In-depth study guide, washout
biology, and quiz solutions
🛠️
[Hands-on 4-Step Tutorial] "Follow this exact sequence"
Step 1 [Resource Retrieval]: Scan the QR code or visit the repository link to download all 5 Chapter 2 files
into your local directory (e.g., stats_ch2/).
Step
2
[Generative
AI
Matrix
Synthesis]:
Paste
[Golden
Prompt
2-1]
from
06_AI_Golden_Prompts_Ch2.md into ChatGPT or Claude. Verify that the AI selects a within-subjects
architecture and generates a 2x2 balanced sequence roster with JSON schema.
Step 3 [Run Statistical Python Verification]: Open your terminal, navigate to your working folder, and
execute the automated counterbalancing verification script:
python3 09_verify_counterbalancing_and_power.py
Step 4 [Cross-Validate & Self-Diagnose]: Compare terminal computations and AI outputs against [Figure
2-5] on the following page, checking off all 4 self-diagnosis points.
23
Verification Guide
Execution Output Cross-Validation & 4-Point Self-Diagnosis
"Here is what a successful execution looks like." Cross-examine your terminal numerical output (top)
and generative AI matrix diagnosis report (bottom) against Figure 2-5 to confirm complete statistical
integrity.
[Figure 2-5] Hands-on Output Verification: (Top) Python Terminal Numerical Console / (Bottom) Generative AI Matrix
Diagnosis Report
✅Four-Point Self-Diagnosis Checklist for Valid Execution
✓ [Check 1] 40 Observations & 50:50 Counterbalancing: Did the terminal confirm an exact
50:50 allocation (Order_A_B: 20 (50.0%) | Order_B_A: 20 (50.0%))?
✓ [Check 2] Paired t-test & Large Cohen's dz: Did repeated measures yield a statistically
significant latency reduction (t(39) = 27.65, p < 0.001, Cohen's dz = 4.37)?
✓ [Check 3] Standard Error (SE) Precision Boost: Did removing between-subject variance shrink
the standard error from
down to
?
✓ [Check 4] 48-Hour Washout Specified: Does the AI report explicitly enforce a 48-hour
recovery interval to fully clear caffeine metabolites and eliminate carryover noise?
NEXT CHAPTER PREVIEW
Chapter 3. Data Tables and Synthetic Simulation
Generating Production-Grade Datasets with Python NumPy & AI: Normal Distributions, Skewness, and
Missingness Injection
➡️
SE = 0.90 ms
SE = 0.67 ms
24
2.7 Chapter 2 Key Takeaways and Experimental Decision Matrix
Students and novice researchers frequently ask: "How do I determine whether my research
demands a between-subjects or within-subjects design?" The answer hinges upon 'Treatment
Reversibility' and 'Participant Scarcity'. Keep this decision compass firmly in mind:
Design
Paradigm
When Should You Use It?
Primary
Methodological
Threat
Prescribed Quality
Control
Between-
Subjects
(Independent
Measures)
•
Irreversible
learning
(e.g.,
teaching an algorithm)
•
Permanent
surgical
or
psychological treatments
•
Deception
studies
where
viewing both arms ruins the test
The
Curse
of
Individual Differences
(Person-to-person
noise
inflates
error
variance)
Random Assignment
(Coin flip/shuffle)
or
Matched
Pairs
Design
Within-
Subjects
(Repeated
Measures)
• High participant recruitment
cost / small sample
•
Measuring
fine-grained
cognitive/physiological deltas
• Short-term, fully reversible
interventions (e.g., drinks, UI)
Temporal
Order
Effects
(Practice,
fatigue,
carryover
contamination)
Balanced
Latin
Square
+ Biological Washout
Period
Mixed Factorial
(Split-Plot
Design)
•
Evaluating
fixed
subject
factors
(gender,
grade)
alongside
repeated treatment conditions
(Interface
A
vs
B)
simultaneously
Complex
Factorial
Interactions
Two-way Mixed ANOVA
& Simple Effects Post-
hoc Testing
🎓 Chapter 2 Three-Minute Master Takeaway
No Causation Without Comparison: Much like Netflix's A/B tests, disciplined comparison against an
unmanipulated baseline is the only key to causal truth.
Random Assignment Rescues Between-Subjects Testing: When evaluating disparate human
beings, stochastic shuffling must disperse individual variance evenly.
Within-Subjects Testing is the Sovereign of Statistical Power: Comparing a subject against
themselves eliminates personal noise, multiplying empirical sensitivity.
Counterbalancing Erases the Arrow of Time: Practice and fatigue biases are neutralized through
the mathematical magic of Balanced Latin Squares and washout intervals.
"You have mastered the architectural blueprint of rigorous experimental design."
In Chapter 3, we breathe life into our experimental matrices with Python NumPy and Generative AI,
generating synthetic datasets mirroring human responses with realistic normal distributions, skewness, and
missingness!
25
제2장 실험 매트릭스와 피험자 설계 핵심 아키텍처피험자 간 설계(Between-Subjects) vs 피험자 내 설계(Within-Subjects) 메커니즘이월 효과(Carryover Effect) 및 연습 효과 발생 경로라틴 방격(Latin Square) 조건을 활용한 자극 순서 역균형화무작위 블록 배정 및 라틴 방격 시뮬레이션 콘솔 출력
🇰🇷 한국어 정규 에디션 (교보문고 바로출판 POD 120p 완제 원문) 🇰🇷 한국어 에디션 (KO) 🇺🇸 Global Edition (EN) CHAPTER 05 AI를 활용한 핵심 모수 통계 추출과 결과 해석 다중 선형 회귀부터 Two-Way ANOVA, 정밀 데이터 테이블 설계 및 학술 차트 시각화까지 [그림 5-0] AI 다변량 통계 분석 연구실: 복잡한 수학 공식 대신 3차원 회귀 평면과 감성 텍스트를 시각화하여, AI와 함께 변수 간의 숨은 인과 관계를 직관적으로 해독하는 최첨단 연구 환경. 🎯 제5장 핵심 학습 목표 (고등학생도 3초 만에 꿰뚫는 데이터 과학의 핵심) 1. 다중 회귀의 입체적 기하학: 점들을 잇는 단순한 직선 하나를 넘어, 여러 원인이 얽힌 3차원 공간에서 최적의 '회귀 평면'을 찾는 원리를 이해합니다. 2. 회귀계수의 본질: 비표준화 계수 B의 실생활 단위 의미와 표준화 계수 β를 통해 어떤 원인이 가장 강력한지 서열을 매깁니다. 3. 5단계 통계 판별 로드맵: 연구 질문과 변수 유형에 따라 t-검정, ANOVA, 다중회귀를 단 3초 만에 판별하는 결정 트리를 마스터합니다. 4. 합리적 데이터 구조 & 구글 드라이브 실습: Long vs Wide 포맷 설계 및 구글 드라이브 실습 키트(CSV/파이썬)의 1클릭 실행법을 체득합니다. 5. 300 DPI 출판용 그래프 시각화 & AI 프롬프트: 바이올린 플롯, 신뢰대역 회귀도, 잔차 진단도를 파이썬과 AI로 추출합니다. PART 02 · STATISTICAL MECHANISMS & AI DECODING 62 5.1 MULTIVARIATE MODELING 5.1 단순 선형에서 다중 회귀로: 한 걸음 더 들어가는 다변량 모델링 원인이 단 하나뿐인 세상은 없다: 1차원 직선에서 3차원 '회귀 평면'으로의 도약 여러분이 오늘 본 시험 점수는 단순히 어제 책상에 앉아 공부한 ...
🇰🇷 한국어 정규 에디션 (교보문고 바로출판 POD 120p 완제 원문) 🇰🇷 한국어 에디션 (KO) 🇺🇸 Global Edition (EN) CHAPTER 01 가설 수립과 변수 명세 일상의 막연한 호기심을 AI가 이해하는 날카로운 데이터 잣대와 조작적 정의로 바꾸기 [그림 1-0] AI와 함께하는 신나는 연구 탐험: 일상의 사소한 호기심도 AI와 함께 올바른 잣대를 세우면 위대한 과학적 발견이 됩니다. 🎯 제1장 핵심 학습 목표 (고등학생부터 연구원까지 누구나 꿰뚫는 원리) 1. AI의 거짓말(환각) 차단하기: 왜 AI에게 "이 앱 공부에 도움 돼?"라고 물으면 엉터리 답을 내놓는지, 그 원인과 '조작적 정의'의 위력을 배웁니다. 2. 검은 백조와 탐정의 원칙: 과학적 가설은 "내 생각이 맞다"고 우기는 게 아니라, 법정의 '무죄 추정'처럼 "틀렸음을 증명할 예외(반증)"를 찾는 게임임을 이해합니다. 3. 개구리 경주와 4대 척도: 1등과 2등의 점수 차이는 1점일 수도, 50점일 수도 있다! 왜 등수의 평균을 구하면 AI가 망가지는지 4가지 숫자 계급을 마스터합니다. 4. 아이스크림의 거짓말(교락 변수): 아이스크림 판매량과 물놀이 익사 사고가 함께 늘어난다고 해서 아이스크림이 범인일까? 숨어있는 진짜 범인(날씨)을 밝혀냅니다. 5. AI 골든 프롬프트 1-1 실전 활용: 내가 가진 사소한 아이디어를 입력하여, 결측치 없는 머신 판독형 JSON 연구 계획서와 가상 데이터셋을 즉시 뽑아냅니다. PART 01 · FOUNDATION ARCHITECTURE · PAGE 7 7 SECTION 1.1 1.1 왜 AI에게 "이 앱 공부에 도움 돼?"라고 물으면 안 될까? 주관적 형용사의 함정과 기계를 작동시키는 '조작적 정의(Operational Definition)' 친구들과 주말...
🇰🇷 한국어 정규 에디션 (교보문고 바로출판 POD 120p 완제 원문) 🇰🇷 한국어 에디션 (KO) 🇺🇸 Global Edition (EN) APPENDIX A 부록 A. 통계 검정 선택 원페이지 결정 로드맵 연구 질문, 종속변수 척도, 집단 수, 정규성 만족 여부에 따른 3초 통계 모델 결정 트리 연구 현장에서 어떤 분석 기법을 선택해야 할지 혼란스러울 때, 아래의 3단계 의사결정 순서도를 따라가면 단 3초 만에 최적의 모수/비모수 통계 모델을 선택할 수 있습니다. 연구 질문 및 목적 독립변수 (X) 종속변수 (Y) 정규성 만족 (모수 통계) 정규성 위반 (비모수 대안) 두 집단 평균 비교 (서로 다른 사람) 범주형 (2집단) (예: AI군 vs 통제군) 연속형 (등간/비율) (예: 점수, 완료율) 독립표본 t-검정 (Independent t-test) 맨-휘트니 U 검정 (Mann-Whitney U) 동일 집단 전후 비교 (동일인의 사전-사후) 범주형 (2시점 반복) (예: 교육 전 vs 교육 후) 연속형 (등간/비율) (예: 반응시간 차이) 대응표본 t-검정 (Paired t-test) 윌콕슨 부호순위 검정 (Wilcoxon Signed) 세 집단 이상 비교 (1개 요인) 범주형 (3집단 이상) (예: A vs B vs C) 연속형 (등간/비율) (예: 학업 성취도) 일원 분산분석 (One-Way ANOVA) 크루스칼-월리스 검정 (Kruskal-Wallis H) 두 요인의 교차 효과 (2×2 요인 설계) 범주형 2개 요인 (예: 처치 × 숙련도) 연속형 (등간/비율) (예: 시험 점수) 이원배치 분산분석 (Two-Way ANOVA) 비모수 순위 분석 또는 붓스트래핑 (5,000회) 연속형 변인 간 예측 (인과 및 영향력 검증) 연속형 1개 이상 (예: 사용시간, 감성점수) 연속형 (등간/비율) (예: 최종 성과 지표) 다중 선형 회귀분석 (Multiple Regression) 강건 ...