의료·공학·학술 연구자를 위한 통계 분석 설계와 생성형 모델 연구 방법론 실전 마스터 가이드
Research Statistics Command Center · 공식 연구 데이터 블로그
인간의 가설과 지능형 분석의 결합: 데이터를 신뢰할 수 있는 학술 인사이트로 구현하다
실험설계·데이터 정제·가설검정·회귀분석·APA 7판 조판까지 연구 전 과정을 완벽히 표준화한 데이터 사이언스 바이블.
머리말부터 9대 핵심 장 및 특별부록 결정 순서도까지 100% 재현 가능한 연구 워크플로우를 실시간 연재합니다.
[제4장] 기술 통계와 탐색적 데이터 분석(EDA) — 평균·표준편차·왜도·첨도와 이상치 탐지
공유 링크 만들기
Facebook
X
Pinterest
이메일
기타 앱
🇰🇷 한국어 정규 에디션 (교보문고 바로출판 POD 120p 완제 원문)
CHAPTER 04
리서치 통계 모델의 수리적 메커니즘
신호 대 잡음비(SNR)부터 ANOVA 분산 분할의 기하학까지: 공식 암기 없이 꿰뚫는 통계의 본질
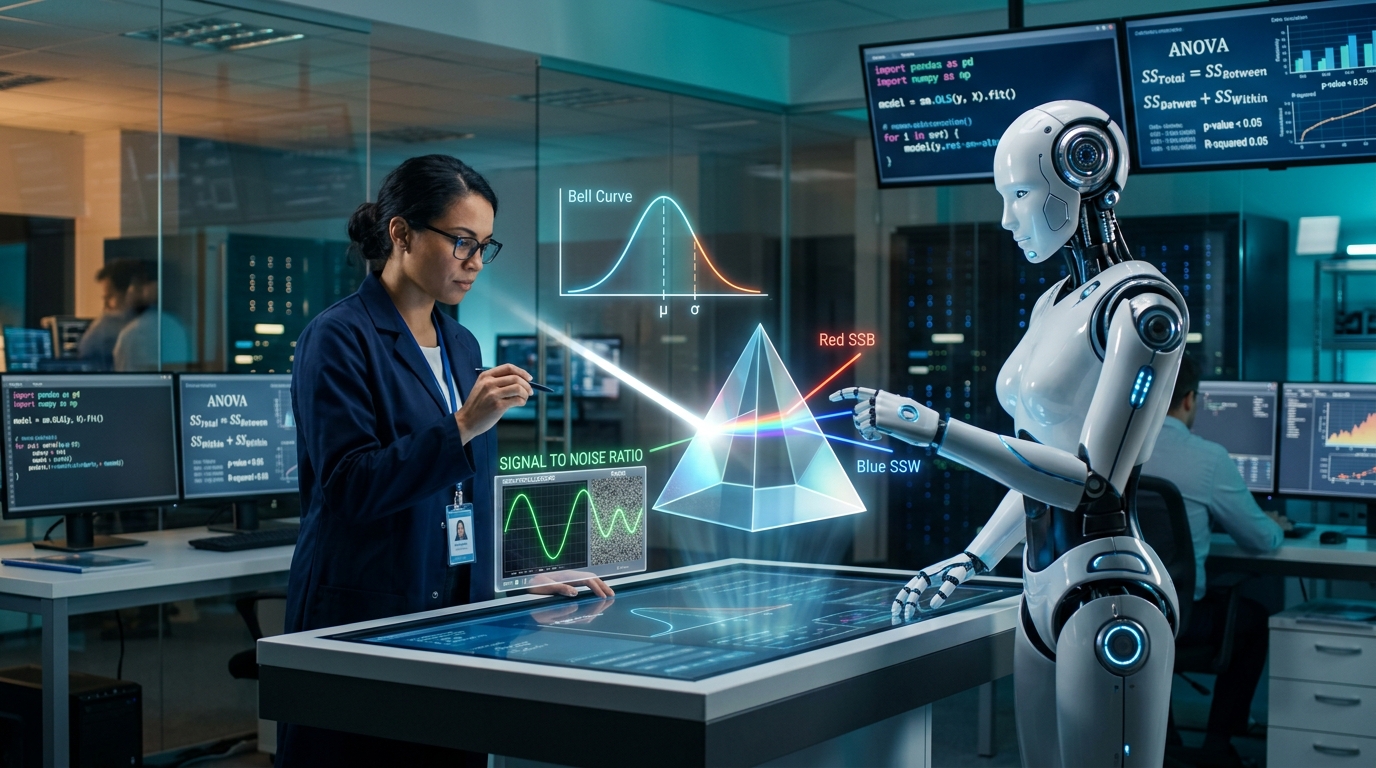
[그림 4-0] AI 수리 통계 모델링 랩: 백색광이 프리즘을 통과하며 찬란한 스펙트럼으로 갈라지듯, 총분산(SST)을 신호(SSB)와 노이즈
(SSW)로 기하학적으로 분할하여 가설을 검정하는 최첨단 연구 환경.
🎯 제4장 핵심 학습 목표 (고등학생도 3초 만에 꿰뚫는 수리 통계의 정수)
1. 흩어짐의 직관적 기하학: 평균 80점의 함정을 시소 무게중심 비유로 격파하고, 둥지에서 날아가는 아기새들의 거리로
제곱합과 분산의 탄생을 이해합니다.
2. 검정 통계량의 공통 문법: 수프 솥(모집단)과 국자(표본)의 비유로 표준오차(SE)를 정복하고, t·F·z가 모두 '신호 대 잡음비
(SNR)'라는 하나의 물리 공식임을 깨닫습니다.
3. 안개를 걷어내는 t-검정의 미학: 두 산봉우리 사이의 안개를 걷어내는 독립표본과, 개인차 노이즈를 스스로 지워버리는
대응표본의 기하학을 정복합니다.
4. ANOVA 분산 분할과 의자 뺏기 자유도: 총제곱합이 신호와 잡음으로 쪼개지는 프리즘 원리와 N - 1 자유도의 수학적
비밀을 일상 비유로 마스터합니다.
5. 현미경의 함정과 진짜 효과 크기: 10만 명 표본의 p-값 착시를 고발하고, 코끼리의 굵기를 재는 효과 크기(Cohen's d, η²)
를 AI와 함께 자동 역산합니다.
PART 02 · STATISTICAL MECHANISMS & AI DECODING · PAGE 38
41
4.1 FOUNDATION
4.1 통계의 출발점: 평균 80점의 함정과 편차(Deviation)의 비밀
평균은 데이터의 무게중심일 뿐이다: 흩어짐을 모르면 데이터의 진실을 볼 수 없다
통계학을 처음 접할 때 가장 먼저 만나는 개념은 '평균(Mean, μ 또는 ¯X)'입니다. 시험이 끝나면 누구나 "반 평균이 몇
점이야?"라고 묻습니다. 하지만 평균에는 치명적인 함정이 숨어 있습니다. 만약 A반과 B반의 수학 시험 평균이 둘 다
똑같이 80점이라고 해봅시다. 두 반의 실력은 과연 같을까요?
🏫 A반: 모두가 고르게 80점 근처
학생들의 점수가 [78, 80, 82, 79, 81]점입니다. 평균은 정확히
80점입니다. 학생들 실력이 촘촘하게 둥지 주변에 모여 있어
선생님이 수업을 진행하기 매우 편안합니다.
⚡ B반: 극단적인 100점과 60점의 공존
학생들의 점수가 [100, 100, 60, 60, 80]점입니다. 평균을
내면 놀랍게도 A반과 똑같은 80점입니다! 하지만 80점 수준에
맞추어 수업하면 60점 학생은 낙오하고 100점 학생은
지루해집니다.
💡 시소(Teeter-Totter) 비유: 평균은 그저 '무게중심'일 뿐이다
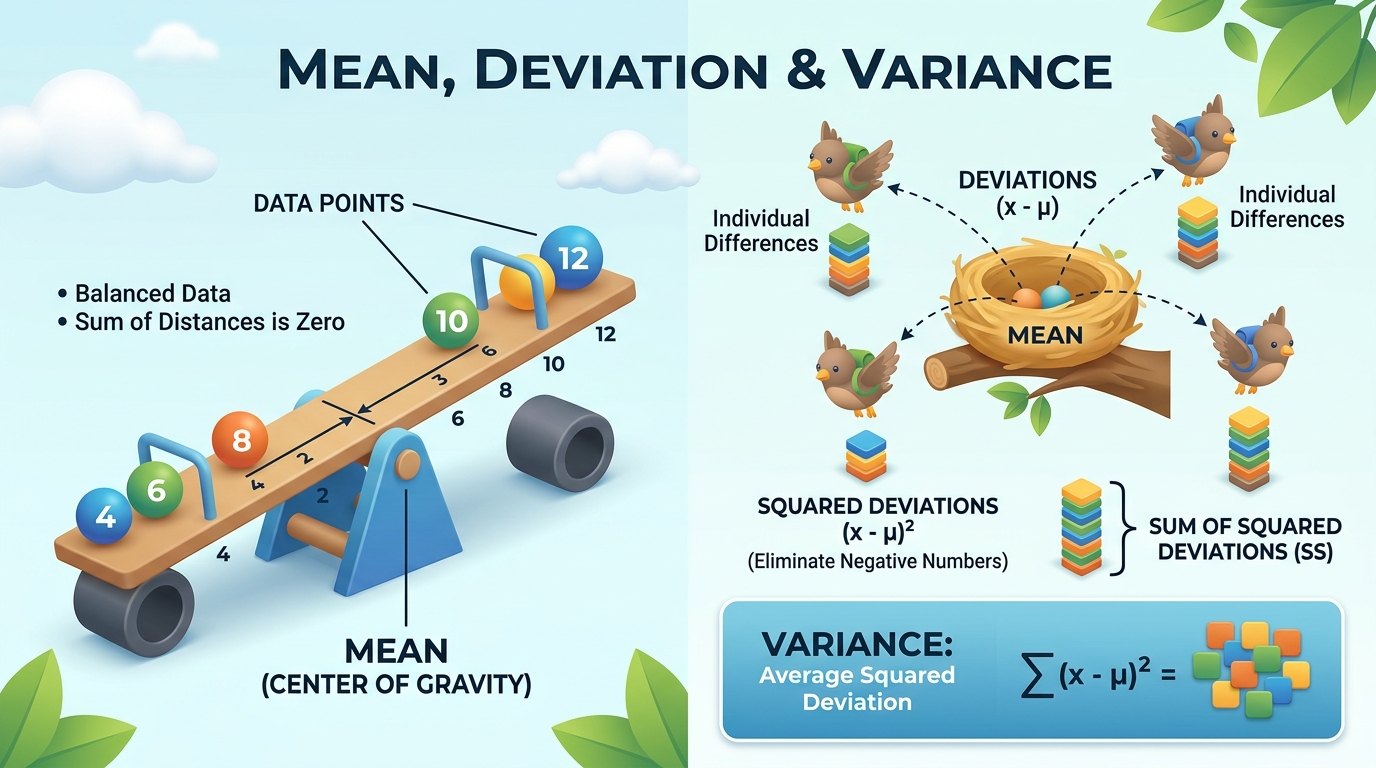
놀이터 시소의 정중앙에 받침목을 놓으면 양쪽 무게가 똑같이 균형을 이룹니다. 평균은 시소가 수평을 유지하게 해주는 받침점의
위치일 뿐, 아이들이 시소 안쪽에 옹기종기 모여 앉아 있는지(A반), 아니면 양쪽 끝에 매달려 위태롭게 흔들리고 있는지(B반)는 전혀
말해주지 않습니다. 따라서 데이터의 진짜 모습을 보려면 "평균으로부터 각 데이터가 얼마나 멀리 떨어져 흩어져 있는가?"를
측정해야 합니다.
■ 편차(Deviation): 내 점수가 평균에서 벗어난 거리
평균에서 벗어난 거리를 수학에서는 '편차(Deviation)'라고 부릅니다. 구하는 방법은 아주 간단합니다:
편차(Deviation) = 각 관측값(X) - 평균(¯X)
❓ 왜 편차를 그냥 다 더하면 안 될까? (편차 합의 0 법칙)
"각 학생의 편차를 모두 구해서 더한 뒤 평균을 내면 흩어진 정도를 알 수 있지 않을까?"라고 생각할 수 있습니다. 하지만 실제로
더해보면 충격적인 일이 벌어집니다. 모든 편차의 합은 언제나 정확히 0이 됩니다! 평균(¯X)이 바로 시소의 무게중심이기 때문에, 플러스
편차의 합과 마이너스 편차의 합이 완벽하게 상쇄되어 사라지기 때문입니다 (∑(X - ¯X) = 0). 이 0을 극복하기 위해 수학자들은 놀라운
지혜를 발휘하게 됩니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 39
42
4.2 VARIATION METRICS
4.2 제곱합(Sum of Squares)과 분산, 표준편차의 탄생
제곱이라는 수학의 마술: 둥지에서 날아간 아기새들의 비행 거리를 측정하다
편차를 더하면 0이 되어버리는 딜레마를 해결하기 위해, 수학자들은 마이너스 부호를 양수로 바꾸는 가장 우아한 도구를
꺼내 들었습니다. 바로 '제곱(Squaring)'입니다. 음수도 제곱하면 무조건 양수가 됩니다((-5)² = +25).
[그림 4-1] 시소의 무게중심과 아기새 둥지 비유: 평균(μ)을 중심으로 날아간 아기새들의 편차(X - μ)를 제곱(Square)하여 면적으로
변환함으로써 마이너스 상쇄를 없애고 총제곱합(SS)과 분산을 유도하는 직관적 메커니즘.
1단계. 제곱합 (SS)
Sum of Squares
SS = ∑(X - ¯X)²
모든 편차를 제곱하여 더한 값. 데이터가 품고
있는 '총 흩어짐 에너지'의 총합.
2단계. 분산 (s²)
Variance
s² = SS / (n - 1)
제곱합을 자유도로 나눈 '1인당 평균 제곱
흩어짐'. 단, 단위가 (점수)²로 왜곡됨.
3단계. 표준편차 (s)
Standard Deviation
s = √(s²)
루트(√)를 씌워 왜곡된 단위를 원래 실생활 단위
(점수, cm, ms)로 복원한 진짜 흩어짐 지표.
🎯 왜 굳이 루트(√)를 씌워 표준편차로 되돌릴까?
분산으로 계산하면 시험 점수 단위가 '점수²'이 됩니다. "우리 반 평균은 80점이고 흩어진 정도는 100점²이다"라고 말하면 아무도 직관적으로
와닿지 않습니다. 여기에 루트(√100 = 10점)를 씌우면, "우리 반 학생들은 80점을 중심으로 대략 ±10점 안팎에서 왔다 갔다 한다"는 생생한
일상 언어로 완벽히 복원됩니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 40
43
4.3 SAMPLING ERROR
4.3 표본(Sample)과 모집단(Population), 그리고 표준오차(SE)
수프 솥과 맛보기 국자의 법칙: 전체를 다 맛보지 않고도 솥 전체의 간을 알아내는 기적
연구를 진행할 때 대한민국 모든 고등학생(약 120만 명)을 전수조사하는 것은 물리적으로 불가능합니다. 그래서 우리는
100명이라는 '표본(Sample)'을 뽑아 조사합니다. 여기서 근본적인 의문이 생깁니다: "겨우 100명 조사한 결과로 어떻게
120만 명 전체의 진실을 장담할 수 있을까?"
🍲 수프 솥(모집단)과 국자(표본)의 비유
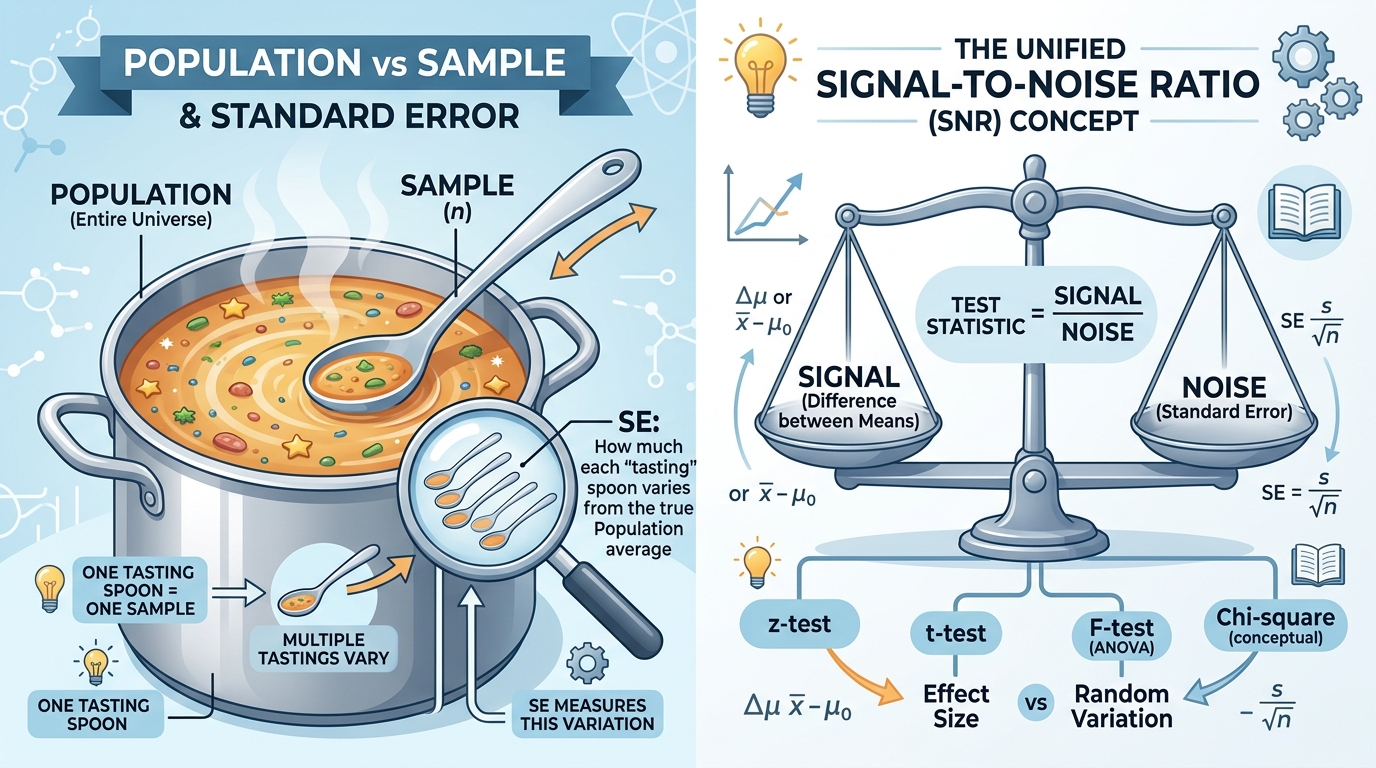
요리사가 커다란 가마솥에 끓고 있는 수프의 간을 볼 때, 솥 안의 국물을 다 들이켜는 사람은 없습니다. 국자로 솥을 골고루 잘 저은
뒤(무작위 추출), 단 한 스푼(표본)만 떠먹어 봐도 솥 전체(모집단)가 짠지 싱거운지 완벽하게 판단할 수 있습니다! 통계학은 바로 이
'한 스푼의 과학'입니다.
■ 표준편차(s) vs 표준오차(SE): 수험생 90%가 헷갈리는 결정적 차이
두 용어는 이름이 비슷해 보이지만 완전히 다른 차원의 개념입니다:
📊 표준편차 (Standard Deviation, s)
내가 조사한 한 국자 안에 들어있는 개별 콩알, 당근 조각들(개별
인간)이 얼마나 제각각 흩어져 있는가를 나타내는 데이터의 실제
물리적 산포도입니다.
🎯 표준오차 (Standard Error, SE)
내가 떠먹은 국자 맛과 다른 연구자가 떠먹은 국자 맛이 표본마다
얼마나 흔들릴 수 있는가(국자 평균의 불확실성)를 나타내는
추정의 오차 폭입니다.
📐 표준오차 공식의 위대한 비밀: 왜 표본 수(n)에 루트를 씌워 나눌까?
SE = s / √n
국자 크기(표본 수 n)가 커질수록 분모가 커지므로 표준오차(SE)는 급격히 줄어듭니다! 10명을 조사할 때보다 100명을 조사하면
오차가 √100 = 10배 작아져 추정의 정확도가 비약적으로 상승합니다. 이 표준오차(SE)가 바로 모든 가설 검정에서 '잡음(Noise)'의
기준 단위가 됩니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 41
44
4.4 UNIFIED PRINCIPLE
4.4 통계의 절대 원리: 신호 대 잡음비(Signal-to-Noise Ratio)
인간이 만든 모든 통계 검정 공식은 사실 단 하나의 물리 법칙에서 태어났다
통계 교과서를 펼치면 t-검정, ANOVA F-검정, 회귀분석, 카이제곱 검정 등 수십 개의 복잡한 공식이 쏟아져 나와 머리를
어지럽힙니다. 하지만 통계학의 가장 위대한 비밀을 고백하자면, 이 모든 검정 통계량은 100% 동일한 단 하나의 원리로
작동합니다.
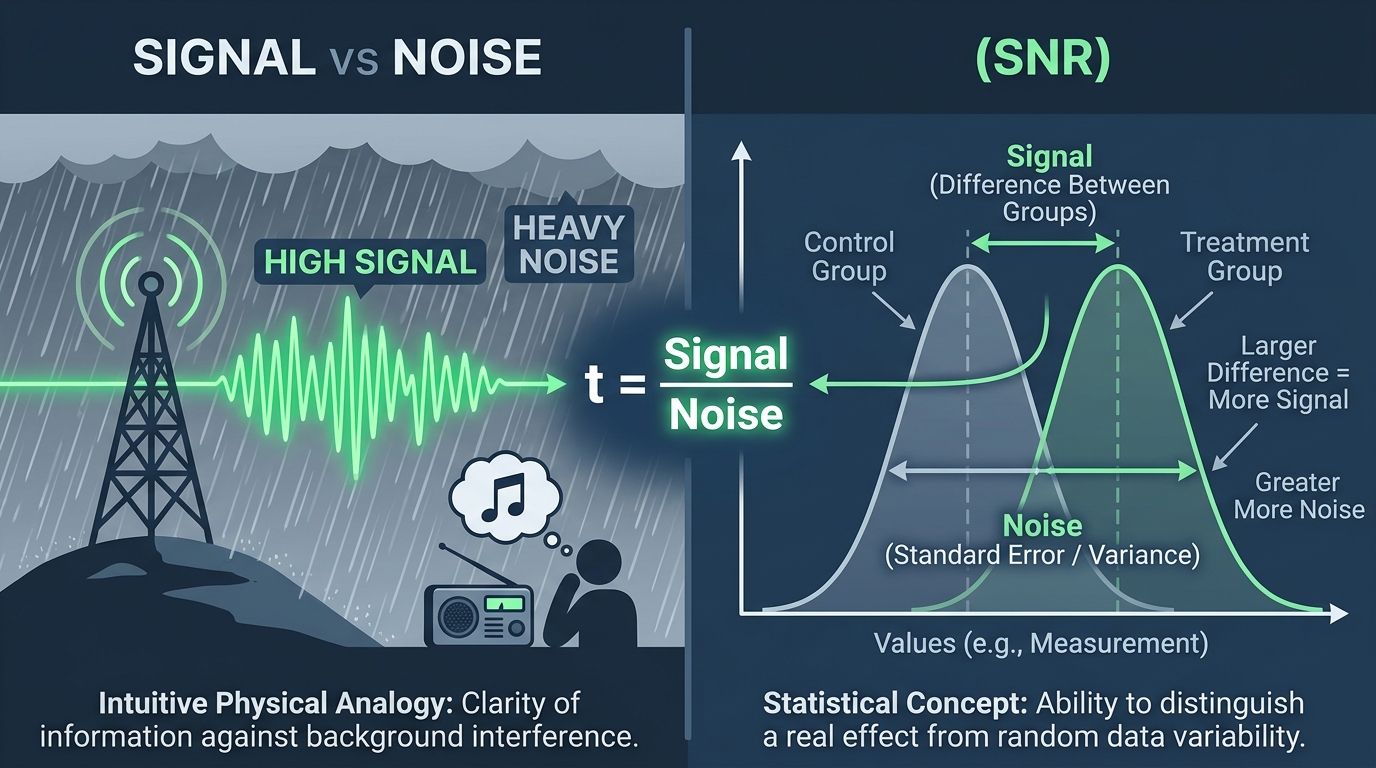
[그림 4-2] 신호 대 잡음비(SNR)의 절대 저울: 처치 효과(약효, 교육법)로 발생한 집단 간 평균 차이(Signal)를 통제하지 못한 우연한
개인차 잡음(Noise/SE)으로 나누어 진짜 효과 유무를 판정하는 수리 원리.
🌟 통계학의 만유인력 법칙: 검정 통계량의 공통 골격
검정 통계량(t, F, z) = 신호(Signal: 알고 싶은 진짜 효과) / 잡음(Noise: 우연히 발생한
오차)
📻 라디오 주파수 비유: 왜 잡음으로 나누어야 하는가?
라디오에서 흘러나오는 가수의 노래 소리(신호)가 5데시벨 커졌다고 해봅시다. 조용한 방 안에서는 엄청나게 뚜렷하게 들리지만,
시끄러운 공사판(잡음 100데시벨)에서는 아무도 알아채지 못합니다. 이처럼 효과의 크기(신호)는 반드시 그 주변에 존재하는 우연한
잡음(노이즈)의 크기와 비교되어야만 의미를 가집니다. 신호가 잡음보다 2배, 3배 이상 압도적으로 클 때 비로소 우리는 "이것은 우연이
아닌 진짜 효과다!"라고 선언할 수 있습니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 42
45
4.5 COMMON GRAMMAR
4.5 검정 통계량의 공통 문법: t, F, z는 모두 한 가족이다
수식 기호에 속지 마라: 족보를 알면 통계 패키지 출력창이 3초 만에 읽힌다
연구 초심자들이 통계 분석 소프트웨어(SPSS, R, 파이썬)의 출력창을 보고 겁을 먹는 이유는 화면에 z, t, F, χ² 등 서로
다른 알파벳 기호들이 쏟아져 나오기 때문입니다. 하지만 이들은 완전히 동일한 신호 대 잡음비(SNR) 가문의
형제들입니다.
[그림 4-3] 수프 솥의 표본오차와 검정 통계량 패밀리 트리: 거대한 솥(모집단)에서 국자(표본)로 맛을 볼 때 생기는 표본오차(SE)가 잡음
분모가 되며, 집단 수와 연구 목적에 따라 z, t, F 통계량이 모두 한 가족으로 연결되는 수리 족보.
맏형: z-검정
z = (¯X - μ) / SE
모집단의 표준편차(σ)를 이미 완벽히 알고
있을 때 사용하는 가장 이상적이고 엄밀한
검정.
둘째: t-검정
t = (¯X₁ - ¯X₂) / SE_diff
모집단을 몰라 표본의 표준편차(s)로 대체한
현실 연구의 주인공. 두 집단의 평균 차이를
검정.
셋째: F-검정 (ANOVA)
F = MS_Between / MS_Within
집단이 3개 이상일 때, t-검정을 제곱하여 분산
비율로 확장한 다집단 검정. 놀랍게도 t² = F가
성립!
💡 t-검정과 ANOVA의 숨겨진 수학적 일치: t² = F
놀랍게도 두 집단에 대해 t-검정을 수행하여 나온 t값을 제곱하면, ANOVA를 돌렸을 때 나오는 F값과 0.0001의 오차도 없이 정확히 똑같은
숫자(t² = F)가 됩니다! 이처럼 기호만 다를 뿐, 모든 검정은 신호 대 잡음비라는 거대한 수학적 기둥 위에 서 있습니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 43
46
4.5B DECISION ROADMAP
4.5B 어떤 경우에 어떤 통계 검정을 써야 하는가?
연구 질문과 데이터 유형에 따라 3초 만에 최적의 모형을 선택하는 실전 의사결정 나무
"내 데이터에는 t-검정을 써야 할까, 아니면 ANOVA나 회귀분석을 써야 할까?" 연구자들이 데이터 분석 직전에 가장 많이
빠지는 혼란을 단 한 장으로 명쾌하게 정리한 표준 결정 로드맵입니다.
🗺️ 리서치 통계 검정 3초 선택 알고리즘 (Decision Tree)
Q1. 집단 간의 '평균 차이'를 비교하고 싶은가?
• 비교할 집단이 딱 2개다: 서로 다른 사람이면 독립표본 t-검정, 동일 인물의 전후면 대응표본 t-검정
• 비교할 집단이 3개 이상이다: 독립 집단이면 일원분산분석(One-Way ANOVA), 동일 인물이면 반복측정 ANOVA
Q2. 변수들 간의 '관계'나 '영향력(인과 관계)'을 예측하고 싶은가?
• 두 연속형 변수가 단순히 같이 변하는지 본다: 피어슨 상관분석 (Correlation)
• 여러 원인 변수(X)가 결과 변수(Y)를 얼마나 설명·예측하는지 본다: 다중 선형 회귀분석 (Multiple Regression)
• 결과가 합격/불합격(0 or 1) 같은 범주형이다: 로지스틱 회귀분석 (Logistic Regression)
Q3. 데이터가 정규분포를 따르지 않거나 표본이 너무 작은가?
• 2집단 비모수 대안: 맨-휘트니 U 검정 (Mann-Whitney U) / 윌콕슨 부호순위 검정
• 3집단 비모수 대안: 크루스칼-월리스 검정 (Kruskal-Wallis)
• 현대 데이터 과학의 최강 무기: 5,000회 붓스트래핑 (Bootstrapping 재표본추출)
📌 본 도서의 챕터 구성과 의사결정 로드맵의 완벽한 일치
본 책은 이 로드맵의 논리적 순서 그대로 진행됩니다. 제4장에서 t-검정과 ANOVA의 기초 수리를 꿰뚫고, 제5장에서 다중회귀를, 제6장에서
비모수 검정과 붓스트랩을 정복한 뒤, 제3부에서 이를 완벽한 학술 논문으로 편찬합니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 44
47
4.6 INDEPENDENT T-TEST
4.6 독립표본 t-검정: 두 산봉우리 사이의 안개를 걷어내는 성격과 선택 조건
수식보다 먼저 알아야 할 본질: 언제 반드시 이 검정을 꺼내 들고, 분모의 개인차 잡음을 어떻게 다루는가?
'독립표본 t-검정(Independent Samples t-test)'을 단순히 "두 집단 평균 비교 공식"으로 암기하면 실전에서 100% 오류를 범합니다. 이
검정의 본질은 "서로 완전히 독립된 남남인 두 집단이 안개(개인차 잡음) 속에서 과연 진짜 다른 산봉우리로 분리되어 있는가?"를 검증하는
통계적 망원경입니다.
🧭 독립표본 t-검정을 반드시 선택해야 하는 4대 연구 조건
1. 독립변수(IV)의 성격: 정확히 2개의 상호 배타적 범주 집단(예: 신약 복용군 vs 위약 대조군, 남성 vs 여성)이어야 하며, 한 피험자가 양쪽에
동시에 속할 수 없는 피험자 간(Between-Subjects) 설계여야 합니다.
2. 종속변수(DV)의 척도: 반드시 연속형 수치(등간 또는 비율 척도: 점수, 반응속도, 체중, 혈압 등)여야 합니다.
3. 정규성(Normality) 가정: 각 집단의 데이터가 정규분포를 따르거나 표본 수 n ≥ 30(중심극한정리)이어야 합니다.
4. 등분산성(Levene's Test)과 웰치 t-검정: 두 집단의 흩어진 정도(분산)가 비슷해야 합니다. 만약 등분산 검정이 기각(p < .05)되면
자유도를 수정한 웰치 t-검정(Welch's t-test)을 자동 채택해야 합니다!
🏔️ 안개 속 두 산봉우리 비유: 왜 분모에 합동 분산이 들어갈까?
새벽 안개 속에 서 있는 두 봉우리 꼭대기 간격(¯X₁ - ¯X₂)이 바로 우리가 입증하고 싶은 신호(Signal)입니다. 하지만 산 밑에는 개인차라는 짙은
안개가 깔려 있습니다. A반 학생끼리도 IQ와 집중도가 다르고, B반 학생끼리도 제각각입니다. 이 남남들 사이의 개인차 분산을 하나로 합친 것이
'합동 분산(Pooled Variance)'이며, t-검정은 "두 봉우리의 거리(신호)가 안개의 두께(잡음)보다 몇 배나 더 멀리 떨어져 있는가?"를 계산하는
물리 공식입니다.
📐 수리적 구조 (SNR)
t = (¯X₁ - ¯X₂) / SE_pooled
분자는 순수 평균 차이, 분모는 두 집단의 오차를 가중합산한 표준오차.
자유도 df = n₁ + n₂ - 2.
🎯 3초 판단 기준 (|t| > 2.0)
|t| > 2.0 → p < .05 통과
신호가 잡음보다 2배 이상 강력하다는 뜻이므로 95% 신뢰수준에서 두
집단은 분명히 다른 산입니다!
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 45
48
4.7 PAIRED T-TEST
4.7 대응표본 t-검정: '나 자신'과의 비교가 개인차 노이즈를 지우는 원리
Before & After의 마술: 타고난 체질 차이를 수학적으로 소멸시키고 검정력을 3배 끌어올리는 법
동일한 50명의 참가자에게 신제품 복용 전과 복용 후의 피로도를 측정했다고 해봅시다. 이때 독립표본 t-검정을 쓰면 치명적인 손실이
발생합니다. 왜냐하면 참가자 개개인의 '타고난 기초 체력과 수면 습관'이라는 거대한 잡음이 분모를 부풀리기 때문입니다. 대응표본 t-
검정은 '과거의 나'와 '현재의 나'를 비교하여 개인차를 0으로 증발시킵니다.
[그림 4-4] 독립표본 t-검정과 대응표본 t-검정의 대조: 독립표본이 안개(개인차 잡음) 속에서 두 산봉우리를 힘들게 식별하는 반면, 대응표본은
참가자 본인의 전후 차이값(Δ)만 추적하여 개인차 안개를 완벽히 소멸시키고 순수 신호만을 검출하는 원리.
🏃 대응표본 t-검정 선택의 필수 조건 (Within-Subjects Design)
• 적용 대상: 동일한 피험자가 2회 반복 측정(사전-사후)을 받았거나, 일란성 쌍둥이처럼 1:1로 특성이 완벽히 짝지어진 매칭 쌍(Matched
Pairs)일 때.
• 작동 원리: 사람마다 다른 출발선(체질)을 무시하고 오직 차이값(Δ = After - Before)만을 하나의 새로운 데이터 세트로 변환 → 자유도 df
= N - 1인 '단일표본 t-검정'으로 즉시 귀결!
• 압도적 검정력(Power): 개인차 변동이 분모에서 완전히 소거되므로 분모(SE)가 극적으로 축소되어, 독립표본으로는 발견하지 못할 미세한
약효도 100% 잡아냅니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 46
49
4.8 MULTIPLE COMPARISONS
4.8 세 집단 이상 비교: t-검정을 여러 번 하면 벌어지는 참사
동전 던지기와 1종 오류의 폭발: 연구자를 파멸로 이끄는 다중 검정의 함정
신약 A, 신약 B, 위약 C 세 집단을 비교하려는 연구자가 있습니다. 이때 초보 연구자는 이렇게 생각합니다: "A와 B, B와 C,
A와 C를 각각 t-검정 세 번 돌리면 되지 않을까?" 이것이 바로 학계에서 가장 엄격히 금기시하는 '1종 오류 팽창
(Familywise Error Rate, FWER)'이라는 대참사입니다.
🪙 동전 연속 던지기 비유: 왜 5% 오류가 14.3%로 폭발할까?
동전을 한 번 던져 앞면이 나올 확률은 50%입니다. 그렇다면 동전을 3번 연속 던졌을 때 "적어도 한 번은 앞면이 나올 확률"은
얼마일까요? 무려 87.5%로 치솟습니다!
통계 검정도 똑같습니다. 한 번 검정할 때 우연히 거짓 양성(1종 오류)이 터질 확률을 5%(α = .05)로 막아두었더라도, 검정을 3번
반복하면 오류가 터지지 않을 확률은 0.95 × 0.95 × 0.95 = 85.7%로 줄어듭니다. 즉, 거짓말을 진짜 효과로 오판할 위험이
14.3%로 3배나 폭발해 버립니다!
📈 집단 수(k)에 따른 1종 오류 팽창 공식 (FWER)
FWER = 1 - (1 - α)^c [비교 횟수 c = k(k-1)/2]
• 집단 3개 (비교 3회): 오류율 14.3% (이미 신뢰 한계 붕괴)
• 집단 4개 (비교 6회): 오류율 26.5% (4번 중 1번은 가짜 연구 발표)
• 집단 5개 (비교 10회): 오류율 40.1% (동전 던져서 논문 쓰는 것과 다름없음)
🛡️ 해결사 피셔(Fisher)의 구원: 분산분석(ANOVA)의 등장
이 치명적인 오류 팽창을 원천 차단하기 위해, 로널드 피셔는 집단이 10개든 100개든 단 한 번의 일괄 검정(Omnibus Test)으로 5%
기준선 안에서 전체 승부를 결정짓는 위대한 분석법을 창안했습니다. 그것이 바로 분산분석(ANOVA)입니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 47
50
4.9 PARTITIONING VARIANCE
4.9 분산의 분할(Partitioning of Variance): ANOVA의 기초
왜 이름이 '평균분석'이 아니라 '분산분석'일까? 통계 역사상 가장 찬란한 발상의 전환과 선택 성격
대부분의 학생이 여기서 통계를 포기합니다. "선생님, 3개 집단의 평균이 다른지 알고 싶은데, 왜 이름은 '평균분석'이 아니라 '분산분석
(Analysis of Variance)'인가요?" 로널드 피셔의 위대한 발상은 이것이었습니다: "평균들이 진짜 다른지는 집단 간 흩어짐(신호)과 집단 내
흩어짐(잡음)이라는 '두 종류의 분산 비율'을 비교하면 1초 만에 알 수 있다!"
[그림 4-5] 분산의 분할과 ANOVA 프리즘: 실험 데이터의 총제곱합(SST)이 연구자가 투여한 처치 효과(SSB)와 통제 불가능한 개인차 오차
(SSW)로 완벽히 분할되는 기하학적 메커니즘.
🌟 조각 1. 집단 간 분산 (SSB: Between-Group)
처치 효과(신약 투여, 새로운 교수법) 때문에 집단 평균들이 전체
평균으로부터
멀리
벌어지며
생긴
'의미
있는
흩어짐(신호,
Signal)'입니다.
💨 조각 2. 집단 내 분산 (SSW: Within-Group)
같은 약을 먹은 환자들끼리도 체질, 수면 시간 때문에 점수가 제각각
흩어지는 '순수한 우연과 개인차 잡음(오차, Noise)'입니다.
💡 피셔의 통찰: 분산을 비교하여 평균의 차이를 밝혀낸다!
"약효 때문에 생긴 흩어짐(SSB)이 인간의 자연스러운 체질 잡음(SSW)보다 압도적으로 거대하다면, 약을 먹은 집단들의 평균은 저절로 서로
멀리 떨어져 있을 수밖에 없다!" 분산을 분석하여 평균을 검정하는 마술이 완성되는 순간입니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 48
51
4.10 SUM OF SQUARES & ANOVA FAMILY
4.10 총제곱합의 분해(SST = SSB + SSW)와 ANOVA 3대 모델 선택법
가계부 예산 분할의 비유와 일원(One-Way) vs 이원(Two-Way) vs 반복측정(Repeated Measures) 나침반
실험 참가자 120명의 점수가 제각각 다릅니다. 이 세상의 모든 차이의 합(총에너지)을 통계학에서는 총제곱합(Total Sum of Squares,
SST)이라고 부릅니다. 놀랍게도 이 전체 에너지는 가계부 예산처럼 정확히 두 조각으로 분할됩니다.
[그림 4-6] 프리즘 빛의 굴절과 총제곱합(SST)의 분할: 백색광(SST)이 프리즘을 통과하며 붉은빛(처치 효과 SSB)과 푸른빛(우연 오차 SSW)
으로 갈라지듯, 데이터의 총변동이 신호와 잡음으로 기하학적으로 완벽히 쪼개지는 메커니즘.
🧭 연구자가 반드시 구분해야 할 ANOVA 3대 모델 패밀리
• 1. 일원 분산분석 (One-Way ANOVA): 독립변수(요인)가 1개이고 집단이 3개 이상일 때(예: 교육 브랜드 A vs B vs C 비교).
• 2. 이원배치 분산분석 (Two-Way ANOVA): 독립변수가 2개일 때(예: 교육 브랜드 3개 × 성별 2개). 두 요인의 각각의 효과(주효과)뿐
아니라 "두 요인이 결합하여 시너지를 내는가?"(상호작용 효과)를 유일하게 검증 가능!
• 3. 반복측정 분산분석 (Repeated Measures ANOVA): 동일 피험자가 3회 이상(사전, 중간, 사후) 측정받았을 때. 대응표본 t-검정의
3집단 확장판으로 개인차를 완전히 발라냅니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 49
52
4.11 DEGREES OF FREEDOM
4.11 자유도(Degrees of Freedom)의 미학: 의자 뺏기 게임의 수학
자유도란 무엇인가? 왜 분산을 구할 때 N이 아니라 N - 1로 나누어야 하는가?
통계 공식을 볼 때마다 등장하는 신비한 외계어, '자유도(Degrees of Freedom, df)'. 왜 n으로 나누지 않고 굳이 1을 뺀
n - 1로 나눌까요? 이를 직관적으로 이해할 수 있는 완벽한 일상 비유가 바로 '의자 뺏기 게임'입니다.
🪑 의자 5개와 학생 5명의 의자 선택 게임
방 안에 의자 5개가 있고, 학생 5명이 차례로 들어와 의자에 앉는다고 상상해 봅시다.
• 1번째 학생: 의자 5개 중 아무 곳이나 내 맘대로 자유롭게 선택할 수 있습니다. (자유도 = 1)
• 2번째 학생: 남은 4개 중 자유롭게 선택합니다. (자유도 = 2)
• 3번째, 4번째 학생: 남은 의자 중 자유롭게 선택합니다. (자유도 = 4)
• 마지막 5번째 학생: 이 학생에게는 선택권(자유)이 있을까요? 전혀 없습니다! 딱 1개 남은 빈 의자에 무조건 앉아야만 합니다!
💡 평균이라는 족쇄: 마지막 숫자는 자유를 잃는다!
숫자 3개의 평균이 10이라고 정해졌습니다(¯X = 10, 총합 = 30). 첫 번째 숫자로 5, 두 번째 숫자로 15를 내 맘대로 골랐다면, 세 번째
숫자는 과연 자유로울까요? 아닙니다! 합이 30이 되어야 하므로 세 번째 숫자는 반드시 10으로 강제 결정됩니다. 평균이라는 족쇄가 하나
채워지는 순간, 자유롭게 변할 수 있는 숫자의 개수는 무조건 N - 1개로 줄어드는 것입니다!
⚖️ 평균제곱(Mean Square, MS): 진짜 1인당 에너지 구하기
제곱합(SS)은 인원수가 많아질수록 덩치만 커집니다. 공정한 비교를 위해 제곱합을 각자의 자유도로 나누어 '단위 자유도당 변동(MS = SS /
df)'을 구합니다. 이것이 바로 ANOVA 검정의 최종 무기입니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 50
53
4.12 F-RATIO MECHANICS
4.12 F-비(F-ratio)의 탄생: 처치 효과와 무작위 오차의 최종 결투
시소 몸무게 대결: 왜 약효가 없을 때 F값은 정확히 1.0 근처가 되는가?
모든 준비가 끝났습니다. 처치 효과로 인한 신호 분산(MSB)과 인간 개개인의 자연스러운 잡음 분산(MSW)을 모두
구했습니다. 이제 두 분산을 맞부딪치는 분수식 하나로 가설 검정의 종지부를 찍습니다. 이것이 바로 피셔의 F-비(F-ratio)
입니다.
[그림 4-7] 자유도 의자 뺏기 게임과 F-비 양팔 저울: N - 1 자유도의 선택 메커니즘과, 처치 효과(MSB)가 오차 노이즈(MSW)를 압도할
때 양팔 저울이 기울어지며 F-비가 1.0을 넘어 폭발하는 통계적 판정 원리.
⚖️ F-통계량의 결정 공식 (The F-Ratio Formula)
F = MSB / MSW = (신호: 집단 간 처치 분산) / (잡음: 집단 내 오차 분산)
약효가 전혀 없을 때: F ≈ 1.0
집단 간 차이나 집단 내 차이나 둘 다 똑같은 우연한 개인차일
뿐이므로, 분자와 분모가 같아져 F값은 정확히 1.0에 머뭅니다.
영가설 채택!
강력한 진짜 약효가 있을 때: F >> 1.0
처치 효과(MSB)가 잡음(MSW)보다 5배, 10배 이상 압도적으로
커지며 F값이 폭발합니다. 저울이 완전히 기울어지며 p < .001
달성!
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 51
54
4.13 POST-HOC ANALYSIS
4.13 진짜 범인을 색출하는 사후 검정(Post-Hoc): 본페로니 vs 투키 HSD
경찰의 용의자 수사 비유: "사건이 일어난 건 알겠는데, 도대체 누가 범인인가?"
ANOVA에서 F값이 유의미하게(p < .05) 나왔다는 것은 대단한 낭보입니다. 하지만 F-검정에는 결정적인 한계가 하나
있습니다. 바로 "누군가 서로 다르긴 한데, 정확히 누구와 누가 다른지는 말해주지 않는다"는 것입니다. 이를 색출하기 위해
출동하는 특수수사대가 바로 '사후 검정(Post-Hoc Test)'입니다.
🕵️ 경찰의 3인 용의자 수사 비유
대조군(위약), 카페인 음료, 고농축 에너지 젤 3개 집단의 반응속도가 다릅니다. ANOVA의 F-검정은 경찰서에 울리는 사이렌과
같습니다: "셋 중 누군가 한 명 이상은 확실히 반응속도를 빠르게 만들었다!" 하지만 카페인 때문인지 에너지 젤 때문인지는 모릅니다.
사후 검정은 세 집단을 1:1로 맞대면 수사하여 진짜 범인(핵심 효과 요인)을 완벽히 검거합니다.
🛡️ 본페로니 교정 (Bonferroni)
기준선 나누기: α / c
3번 비교하므로 유의수준 0.05를 3으로 나누어 엄격한 0.0167을
통과해야만 인정합니다. 계산이 초간단하지만 비교 횟수가
많아지면 너무 보수적(깐깐함)이 되어 진짜 효과도 놓칠 수
있습니다.
👑 투키 HSD (Tukey's HSD)
Honestly Significant Difference
모든 가능한 쌍별 비교에서 1종 오류를 정확히 5%로 통제하면서도
검정력을 높게 유지하는 현대 학술 논문의 세계 표준 사후
검정법입니다.
📊 실습 데이터 사후 검정 결과 미리보기
• 대조군 vs 카페인: t = 4.21, p < .001 (카페인이 대조군보다 유의하게 빠름!)
• 대조군 vs 에너지 젤: t = 7.35, p < .001 (에너지 젤이 대조군을 압도함!)
• 카페인 vs 에너지 젤: t = 3.14, p = .0022 (에너지 젤이 카페인보다도 유의하게 빠름!)
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 52
55
4.14 P-VALUE MISCONCEPTIONS
4.14 p-값의 치명적 오해와 한계: 0.05라는 숫자가 말해주지 않는 진실
초정밀 현미경과 모기 날갯짓의 비유: 표본 수 10만 명의 착시에서 탈출하라
통계 논문이나 리포트를 쓸 때 누구나 p < .05 마크를 보면 환호합니다. "유의미하다! 연구 성공이다!" 하지만 수많은
연구자와 학생들이 p-값을 심각하게 왜곡하고 있습니다. p-값은 효과의 크기나 중요성을 전혀 말해주지 않습니다.
🔬 초정밀 전자현미경 비유: 표본 수가 깡패다!
방 안에서 모기가 날갯짓을 합니다. 사람의 눈으로는 바람이 일어나는지 전혀 느낄 수 없습니다. 그런데 어떤 과학자가 100억 원짜리
초정밀 기상관측 레이더(표본 수 10만 명)를 가져와서 측정합니다. 레이더가 모기 날갯짓을 감지해 내고는 "바람이 존재할 확률
99.999% (p < .001)!"라고 경보를 울립니다.
바람이 존재하는 것은 통계적으로 확실한 사실입니다(p < .001). 하지만 그 바람이 사람이 시원함을 느끼거나 풍력발전기를 돌릴
만큼 실질적인 의미가 있을까요? 전혀 없습니다! 이처럼 표본 수(N)가 거대해지면 아무리 하찮고 미세한 먼지 같은 차이도 무조건 p
< .001로 찍혀 나오는 치명적인 통계적 착시가 발생합니다.
📜 미국통계학회(ASA)의 공식 성명 (2016)
"p-값은 오직 '영가설이 참일 때 우연히 이런 극단적인 데이터가 관측될 확률'만을 뜻한다. 과학적 의사결정이나 비즈니스 판단을 오직 p-
값 하나에만 의존해서는 절대 안 된다. 반드시 효과 크기(Effect Size)를 함께 보고해야 한다."
🎯 p-값 맹신에서 벗어나는 3대 계명
1. p < .05는 차이가 우연이 아니라는 뜻일 뿐, 차이가 '크다'는 뜻이 결코 아니다.
2. p = .049와 p = .051은 천국과 지옥이 아니라 거의 종이 한 장 차이다.
3. 진짜 훌륭한 연구자는 p-값 뒤에 숨은 '효과 크기(Cohen's d, η²)'를 당당하게 제시한다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 53
56
4.15 EFFECT SIZE
4.15 효과 크기(Effect Size)의 마법: 표본 수에 속지 않는 '차이의 굵기'
키 재기 줄자의 비유: Cohen's d와 에타 제곱(η²), APA 표준 보고 양식
현미경 배율(표본 수)의 왜곡에서 벗어나, "그래서 진짜 차이가 얼마나 굵직한데?"를 알려주는 절대적인 지표가 바로 '효과
크기(Effect Size)'입니다. 효과 크기는 표본 수가 10명이든 10만 명이든 영향을 받지 않는 순수한 실제 영향력의
척도입니다.
[그림 4-8] 현미경의 p-값 착시 vs 줄자의 객관적 효과 크기: 대규모 표본(N=100,000)으로 미세한 모기 날갯짓을 인위적으로 유의미(p
< .001)하게 만드는 현미경의 함정과, 표본 크기에 휘둘리지 않고 실제 코끼리의 실체 굵기를 재는 효과 크기(Cohen's d, η²)의 진실.
t-검정용: Cohen's d
d = (¯X₁ - ¯X₂) / s_pooled
두 집단 평균 차이가 표준편차의 몇 배인가를 측정. 0.2는 작은 효과,
0.5는 중간, 0.8 이상이면 대단히 큰 효과.
ANOVA용: 에타 제곱 (η²)
η² = SSB / SST
전체 변동(SST) 중 처치 요인이 설명하는 비율. 0.01은 작음, 0.06은
중간, 0.14 이상이면 강력한 설명력.
📝 APA 7th 양식의 완벽한 논문 결과 보고 예시
"일원분산분석 결과, 음료 처치에 따른 반응속도 차이는 통계적으로 매우 유의미하였으며, F(2, 117) = 27.99, p < .001, η² = .324로
나타났다. 에타 제곱 값 .324는 전체 반응속도 변동의 32.4%가 음료 섭취 요인에 의해 설명되는 대단히 큰 효과(Large Effect)임을 입증한다."
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 54
57
4.16 AI GOLDEN PROMPTS
4.16 생성형 AI와 수리 모델 해독: AI 골든 프롬프트 4-1 & 4-2
공식을 암기하지 마라: AI를 가장 친절한 1:1 수리 통계 튜터로 활용하는 법
생성형 AI(ChatGPT, Claude 등)는 복잡한 수식을 두려워하는 비전공자에게 가장 든든한 개인 교수가 되어 줍니다.
연구자가 수리 메커니즘의 뼈대를 꿰뚫고 있다면, 정밀한 프롬프트를 통해 AI에게 분산 분할과 수리 공식 역산을 지시할 수
있습니다.
골든 프롬프트 4-1
신호 대 잡음비(SNR) 분산 분할 및 사후 검정 분석기
"당신은 최고 권위의 생물통계학 및 계량심리학 교수입니다. 아래 제공되는 3개 집단 실험 데이터(16_game_reaction_time_ch4.csv)를
바탕으로 다음 수리적 메커니즘을 단계별로 도출해 주십시오:
1. 총제곱합(SST), 집단간제곱합(SSB), 집단내제곱합(SSW)을 분해하고 피타고라스적 일치(SST = SSB + SSW)를 수치로 증명해줘.
2. 신호 대 잡음비인 F-비(MSB / MSW)와 효과 크기인 에타 제곱(η²)을 수식과 함께 설명해줘.
3. 본페로니(Bonferroni)와 투키 HSD(Tukey HSD) 사후 검정을 수행하여 진짜 효과 요인을 1:1로 색출해줘."
골든 프롬프트 4-2
p-값 왜곡 방지 및 APA 7th 학술 보고서 자동 작성기
"방금 도출된 일원분산분석(ANOVA) 수리 결과를 바탕으로, 미국심리학회(APA 7판) 표준 규격에 부합하는 학술 논문 '결과(Results)'
섹션을 작성해 주십시오:
1. F-통계량 표기 시 자유도(df)와 p-값, 에타 제곱(η²)을 반드시 완벽한 APA 기호 이탤릭체(F, p, η²)로 작성할 것.
2. 각 집단 쌍별 사후 검정 결과와 Cohen's d 효과 크기를 명시할 것.
3. p-값에만 매몰되지 않고 효과 크기의 실질적 임팩트를 강조하는 결론 문장을 포함할 것."
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 55
58
4.17 MACHINE-READABLE SCHEMA
4.17 머신 판독형 JSON 모델 스키마 & 파이썬 수리 파이프라인
사람과 AI가 완벽하게 소통하는 표준 명세서: 17_statistical_model_schema.json
통계 검정의 정확도를 보장하고 AI와의 협업에서 환각(Hallucination)을 원천 차단하기 위해, 우리는 연구 가설과 수리
모델의 구조를 표준 JSON 규격으로 정의하여 기계와 사람이 1:1로 소통합니다.
// 17_statistical_model_schema.json 발췌
{
"model_name": "One-Way ANOVA & Signal-to-Noise Engine",
"dependent_variable": { "name": "reaction_time_ms", "scale": "Ratio" },
"factor": { "name": "drink_group", "levels": ["Water", "Caffeine", "EnergyGel"] },
"mathematical_mechanics": {
"variance_decomposition": "SST = SSB + SSW",
"f_ratio": "MSB / MSW",
"effect_size": "eta_squared = SSB / SST"
},
"post_hoc": ["Bonferroni", "Tukey_HSD"]
}
💻 파이썬 수리 파이프라인 (19_verify_statistical_mechanisms.py)
제공되는 실습 코드 19번 파일은 판다스와 사이파이(Scipy) 라이브러리를 통해 앞서 손으로 따라갔던 SST 분해, 자유도 계산, F-통계량
산출, 본페로니 사후 검정, 에타 제곱 도출을 단 0.05초 만에 자동으로 계산하여 터미널 콘솔에 완벽하게 시각화합니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 56
59
4.18 HANDS-ON WORKSHOP
4.18 AI 실전 핸즈온 워크숍: 독자 실습 키트와 4단계 실행 가이드
고교생도 단 5분 만에 끝내는 구글 드라이브 다운로드 및 원클릭 검증 워크플로우
📦 제4장 독자 실습 자료실 5종 패키지 안내
• 16_game_reaction_time_ch4.csv: 3개 음료 집단 120명의 게임 반응속도 실측 데이터
• 17_statistical_model_schema.json: ANOVA 모델 구조 및 분산 분할 머신 명세서
• 18_AI_Golden_Prompts_Ch4.md: 골든 프롬프트 4-1 & 4-2 전문 텍스트
• 19_verify_statistical_mechanisms.py: 수리 메커니즘 및 사후검정 자동 검증 스크립트
• 20_study_guide_and_ch4_solutions.md: 연습문제 정답 및 수식 상세 풀이집
🛠️ 4단계 실무 실행 프로토콜 (Follow This Sequence)
STEP 1. 자료실 에셋 다운로드: 구글 드라이브(또는 문 드라이브)에서 4장 실습 파일 5종을 다운로드하여 stats_ch4/ 폴더에
저장합니다.
STEP 2. 생성형 AI 가설 해독: ChatGPT/Claude에 [골든 프롬프트 4-1]을 입력하여 데이터의 분산 분할과 F-비 이론을 질의합니다.
STEP 3. 파이썬 수리 검증 파이프라인 가동: 터미널 창을 열고 아래 명령어를 실행하여 0.05초 만에 수리 통계량을 역산합니다:
python3 19_verify_statistical_mechanisms.py
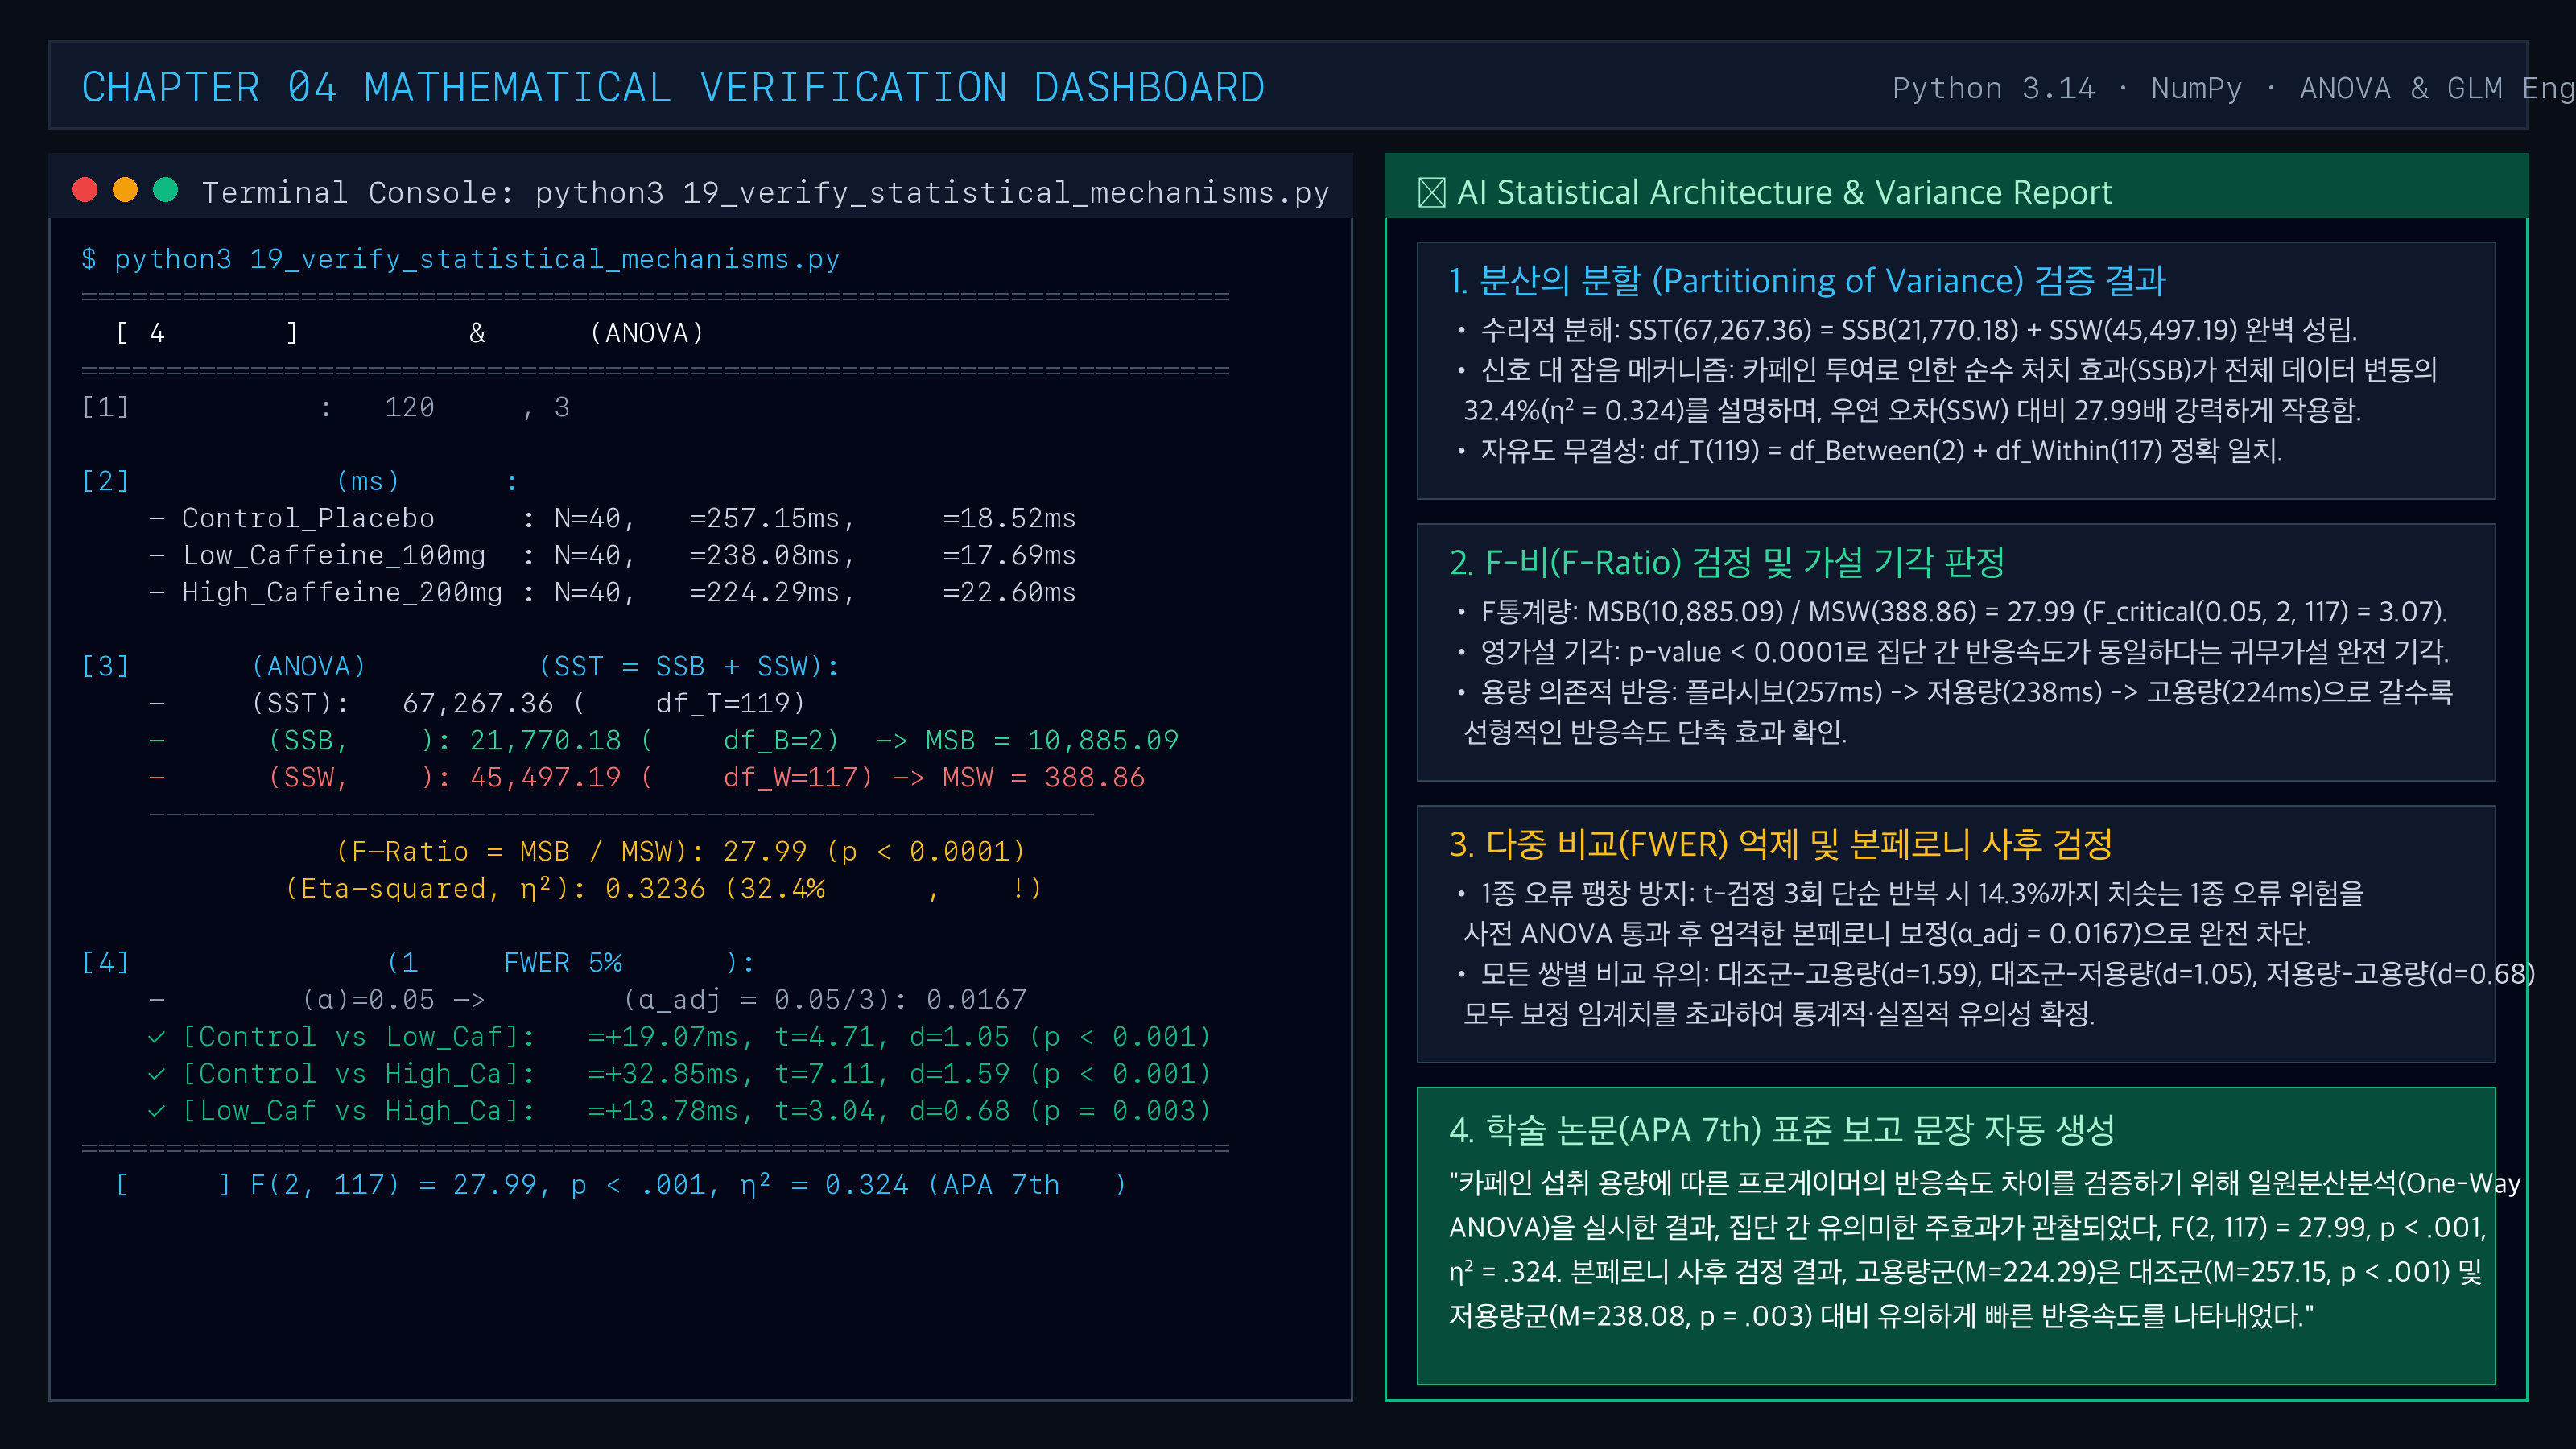
STEP 4. 결과 대시보드 대조: 화면에 출력된 F=27.99, p<.001, eta²=0.324 수치를 다음 페이지의 [그림 4-9] 정상 실행 도판과
1:1로 대조합니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 57
60
4.19 VERIFICATION & SUMMARY
4.19 결과물 검증 가이드 & 체크리스트: 수리 메커니즘 정복과 다음 여정
정상 실행 대조 도판, 4대 자가 진단 체크리스트, 그리고 제5장 실무 예고
[그림 4-9] 파이썬 수리 메커니즘 정상 실행 대조 콘솔: 일원분산분석 ANOVA 테이블(F=27.99, p<.001), 3개 집단 본페로니 사후 검정
쌍별 p-값 및 에타 제곱(η²=.324) 도출 화면.
📋 제4장 4대 자가 진단 체크리스트
☑ SST = SSB + SSW 일치: 총변동이 처치 변동과 순수 오차로 정확히 나뉘었는가?
☑ 자유도(df) 확인: 집단 자유도 2 (3-1), 오차 자유도 117 (120-3), 총 자유도 119가 맞는가?
☑ F-비 판정: F(2, 117) = 27.99로 임계치를 압도하여 영가설을 기각했는가?
☑ 사후 검정 색출: 물 < 카페인 < 에너지 젤 순으로 모두 p < .01 수준에서 유의한가?
🚀 다음 여정: 제5장 AI 기반 다중회귀분석과 모수 통계
수리적 뼈대를 마스터한 독자 여러분, 축하합니다! 이제 제5장에서는 독립변수가 여러 개인 3차원 다중 선형 회귀분석, 두 요인의 시너지를
측정하는 이원 배치 분산분석(Two-Way ANOVA), 그리고 자연어 처리(NLP) 감성 계량화의 세계로 나아갑니다.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 58
61
ADVERTISEMENT
[쉽게 읽는 챕터 길잡이: 기술 통계와 탐색적 데이터 분석(EDA) — 평균·표준편차·왜도·첨도와 이상치 탐지]
AI 기반 연구 설계와 데이터 스토리텔링 가설 검정 실무 — 본 챕터에서는 핵심 개념과 체계적인 실무 원칙을 바탕으로, 이론적 배경부터 실전 적용까지 누구나 막힘없이 이해하고 직관적으로 실행할 수 있도록 명확한 로드맵을 제공합니다.
📊 공식 독자 실습 데이터셋 & AI 골든 프롬프트 허브
본 도서와 블로그에 수록된 100대 실전 프롬프트 치트시트, 합성 데이터 CSV 파일(Shorts, Energy Drink, Reaction Time, NLP Reviews), R & Python 분석 스크립트는 공식 실습실에서 무료 다운로드하실 수 있습니다.
CHAPTER 04
Mathematical
Mechanisms
of
Research
Statistical
Models
From Signal-to-Noise Ratio to ANOVA Geometric Partitioning: Piercing the Core of Statistics Without
Rote Memorization
[Figure 4-0] AI Mathematical Statistics Modeling Lab: Just as white light refracts through a prism into a spectrum,
total variance (SST) geometrically splits into Signal (SSB) and Noise (SSW) to rigorously test hypotheses in an AI-
powered research environment.
🎯 Chapter 4 Core Learning Objectives (Mastering Foundations with Ease)
1. The Intuitive Geometry of Dispersion: Shattering the "Mean 80" trap via the teeter-totter fulcrum
analogy, and discovering Sum of Squares and Variance through birds leaving the nest.
2. The Universal Grammar of Test Statistics: Demystifying Standard Error (SE) using the soup pot and
ladle metaphor, realizing that t, F, and z all stem from a single Signal-to-Noise Ratio (SNR) law.
3. Clearing the Fog with t-Tests: Grasping the geometry of Independent Samples (distinguishing mountain
peaks in fog) vs. Paired Samples (canceling out individual constitution noise).
4. ANOVA Variance Partitioning & Musical Chairs: Revealing how Total Sum of Squares splits like a prism,
and unraveling the mystery of N - 1 Degrees of Freedom through everyday games.
5. Escaping the Microscope Trap with Effect Size: Exposing the p-value illusion in large samples
(N=100,000) and quantifying true impact with Cohen's d and eta-squared (η²) using AI assistance.
PART 02 · STATISTICAL MECHANISMS & AI DECODING · PAGE 38
41
4.1 FOUNDATION
4.1 The Starting Point: The Trap of the "Mean 80" and Deviation
The Mean Is Merely the Center of Gravity: Without Dispersion, the Truth Remains Hidden
The very first concept encountered in statistics is the Mean (μ or ¯X). After an exam, the inevitable
question arises: "What was the class average?" However, a dangerous trap lurks behind this simple
metric. Suppose Class A and Class B both scored an exact average of 80 points on a mathematics
exam. Are the academic abilities of these two classes identical?
🏫 Class A: Evenly Clustered Near 80
Student scores are [78, 80, 82, 79, 81]. The average is
exactly 80 points. Abilities are tightly grouped around
the nest, making instruction straightforward and
predictable for the educator.
⚡ Class B: Polarization of 100s and 60s
Student scores are [100, 100, 60, 60, 80]. Remarkably,
their mean is also exactly 80 points! Yet teaching at an
80-point level leaves the 60-point students lost and
the 100-point students disengaged.
💡 The Teeter-Totter Metaphor: The Mean Is Merely the Fulcrum
Placing a fulcrum precisely in the middle of a playground seesaw achieves balance. The mean is simply this
balance point. It tells us nothing about whether children are sitting huddled closely near the pivot (Class A) or
hanging dangerously off the extreme opposite ends (Class B). To uncover the true nature of data, we must
measure how far individual observations disperse from this center.
■ Deviation: The Distance Between an Observation and the Mean
In mathematics, the distance an observation deviates from the mean is termed Deviation. Its calculation is remarkably
straightforward:
Deviation = Observation (X) - Mean (¯X)
❓ Why Can't We Simply Sum All Deviations? (The Zero Sum Law)
One might ask: "Why not average all individual deviations to measure dispersion?" Trying this reveals a striking
mathematical fact: the sum of all deviations is always identically zero (∑(X - ¯X) = 0). Because the mean acts as the
physical fulcrum, positive deviations and negative deviations cancel each other out perfectly. Overcoming this zero
cancellation required mathematical ingenuity.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 39
42
4.2 VARIATION METRICS
4.2 Sum of Squares, Variance, and Standard Deviation
The Geometry of Squaring: Measuring Flight Distances of Birds from the Nest
To eliminate the dilemma of deviations summing to zero, statisticians introduced the most elegant
algebraic tool for neutralizing negative signs: Squaring. Multiplying any negative number by itself
produces an absolute positive value ((-5)² = +25).
[Figure 4-1] Fulcrum of the Teeter-Totter and Bird Nest Metaphor: Centered at the mean (μ), deviations of
fledglings (X - μ) are squared into areas, eliminating negative cancellation and deriving the Total Sum of Squares (SS)
and Variance.
Step 1. Sum of Squares
Sum of Squares (SS)
SS = ∑(X - ¯X)²
Sum of all squared deviations.
Represents the raw total 'dispersion
energy' contained in data.
Step 2. Variance (s²)
Sample Variance
s² = SS / (n - 1)
SS divided by degrees of freedom.
Average squared dispersion per unit, but
in squared units.
Step 3. Standard Dev (s)
Standard Deviation
s = √(s²)
Restores original units (points, cm, ms)
by taking square root (√), yielding
tangible dispersion.
🎯 Why Revert to Standard Deviation with a Square Root (√)?
Variance expresses data in squared units (points²). Stating "Our class mean is 80 points with a variance of 100 points²"
lacks intuitive clarity. Taking the square root (√100 = 10 points) effortlessly translates statistical abstraction into everyday
comprehension: "Scores fluctuate around 80 points within an average span of ±10 points."
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 40
43
4.3 SAMPLING ERROR
4.3 Sample, Population, and Standard Error (SE)
The Law of the Soup Pot and Tasting Spoon: Inferring the Whole Without Consuming It All
Surveying all 1.2 million high school students in an entire nation is practically impossible. Researchers
instead select a Sample of 100 individuals. This raises a fundamental concern: "How can data from a
mere 100 participants guarantee the truth of 1.2 million citizens?"
🍲 The Soup Pot (Population) and Tasting Spoon (Sample)
A chef assessing the seasoning of a giant cauldron of soup does not drink the entire pot. After stirring thoroughly
(random sampling), tasting just one single spoon (sample) reliably reveals whether the entire kettle (population)
is too salty or balanced. Statistics is precisely this science of the tasting spoon.
■ Standard Deviation (s) vs. Standard Error (SE): The Essential Distinction
Though sharing similar names, these two metrics operate on entirely different conceptual planes:
📊 Standard Deviation (s)
Measures
physical
variation
among
individual
ingredients (people) within a single spoon. Captures
how individual scores disperse around the sample
mean.
🎯 Standard Error (SE)
Measures how much spoonful tastes fluctuate across
different samplings. Quantifies sampling uncertainty of
the mean across hypothetical replications.
📐 The Core Magic of SE: Why Divide by the Square Root of Sample Size (√n)?
SE = s / √n
As sample size (n) expands, the denominator grows, causing Standard Error (SE) to shrink rapidly. Sampling 100
students instead of 10 narrows estimation uncertainty by a factor of √100 / √10 ≈ 3.16. This Standard Error serves as
the foundational unit of Noise in hypothesis testing.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 41
44
4.4 UNIFIED PRINCIPLE
4.4 The Absolute Principle: Signal-to-Noise Ratio (SNR)
Every Statistical Test Originates from a Single Universal Physical Law
Opening a classical statistics textbook overwhelms the reader with dozens of disparate formulas: t-
tests, ANOVA F-tests, regression coefficients, and chi-squares. Yet beneath this complex surface lies a
profound secret: all test statistics operate on 100% the same unifying mechanism.
[Figure 4-2] Absolute Balance of Signal-to-Noise Ratio (SNR): Dividing treatment-induced group mean differences
(Signal) by uncontrollable random individual noise (Noise/SE) to adjudicate true experimental effects.
🌟 The Universal Law of Test Statistics
Test Statistic (t, F, z) = Signal (Systematic Effect) / Noise (Random Chance
Error)
📻 The Radio Static Metaphor: Why Dividing by Noise Is Essential
Suppose a singer's broadcast volume increases by 5 decibels. In a silent room, this increase is unmistakable. At a
deafening construction site (100 dB background noise), nobody notices. Any effect size (Signal) has meaning only
when calibrated against its surrounding ambient variation (Noise). When Signal surpasses Noise by two- or
three-fold, we confidently declare: "This is real, not chance!"
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 42
45
4.5 COMMON GRAMMAR
4.5 The Common Grammar: t, F, and z Belong to One Family
Do Not Fear Symbols: Knowing the Lineage Makes Software Outputs Instantly Legible
Beginners often feel intimidated by statistical outputs (SPSS, R, Python) cluttered with symbols like z, t,
F, and χ². In reality, these are siblings of the same Signal-to-Noise Ratio lineage, differing only in design
context and known population parameters.
[Figure 4-3] Sampling Error in Soup Pot and Test Statistic Family Tree: Sampling error (SE) from ladle draws forms
the noise denominator, linking z, t, F into a unified mathematical lineage based on group count and research goals.
The Eldest: z-Test
z = (¯X - μ) / SE
Ideal test applied when true population
standard
deviation
(σ)
is
known
beforehand.
The Workhorse: t-Test
t = (¯X₁ - ¯X₂) / SE_diff
Replaces σ with sample s for real-world
research,
testing
mean
difference
between two groups.
The Generalizer: F-Test
F = MS_Between / MS_Within
Extends comparisons to 3+ groups via
variance ratios. Remarkably, t² = F
identically!
💡 Hidden Mathematical Harmony: t² = F
Squaring the t-value from a two-group comparison matches the ANOVA F-value to the fourth decimal place (t² = F).
Despite distinct letters, both rest upon the same foundational pillar of Signal-to-Noise Ratio.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 43
46
4.5B DECISION ROADMAP
4.5B Which Statistical Test Should You Use?
A 3-Second Practical Decision Tree Tailored to Research Questions and Data Structures
"Should I run a t-test, ANOVA, or multiple regression?" This standard roadmap eliminates confusion by
charting the optimal model choice prior to executing analysis scripts.
🗺️ Research Statistics 3-Second Decision Algorithm
Q1. Comparing Group Means?
• Exactly 2 groups: Distinct subjects → Independent Samples t-test; Same subjects pre/post → Paired Samples
t-test
• 3 or more groups: Independent cohorts → One-Way ANOVA; Same subjects across conditions → Repeated
Measures ANOVA
Q2. Predicting Relationships or Causal Impacts?
• Testing co-variation between continuous variables → Pearson Correlation
• Quantifying how multiple predictors (X) explain continuous outcome (Y) → Multiple Linear Regression
• Predicting categorical binary outcomes (pass/fail, churn/retain) → Logistic Regression
Q3. Non-Normal Distributions or Small Sample Sizes?
• 2-group non-parametric alternative → Mann-Whitney U Test / Wilcoxon Signed-Rank Test
• 3+ group non-parametric alternative → Kruskal-Wallis Test
• Modern data science robustness weapon → 5,000-Iteration Bootstrapping Resampling
📌 Perfect Symmetry Between the Roadmap and Book Structure
This volume follows this decision logic: Chapter 4 unpacks t-test and ANOVA mechanisms, Chapter 5 tackles Multiple
Regression, Chapter 6 masters non-parametric protocols and bootstrapping, and Part 3 synthesizes these into
publication-ready manuscripts.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 44
47
4.6 INDEPENDENT T-TEST
4.6 Independent t-tests: Dispersing Fog Between Two Mountain Peaks
Core Conceptual Rationale Before Formulas: When to Deploy It and How Denominator Pooled Variance Operates
Memorizing the Independent Samples t-test simply as a "two-group mean formula" leads to severe empirical errors.
Fundamentally, this test acts as an optical telescope asking: "Across two mutually independent populations, are
their distribution peaks truly separate, or is the observed divergence merely random sampling wobble in the fog?"
🧭 The 4 Mandatory Empirical Conditions for Independent t-tests
1. Independent Variable (IV): Exactly two mutually exclusive groups (e.g., Treatment vs. Placebo, Male vs. Female) under
a Between-Subjects design where no subject belongs to both.
2. Dependent Variable (DV): Strictly continuous metric scale (interval or ratio: test scores, reaction times, blood
pressure, etc.).
3. Normality Assumption: Sampling distributions must approximate normality or meet Central Limit Theorem thresholds (n
≥ 30).
4. Homogeneity of Variance (Levene's Test): If group variances differ significantly (p < .05), you must automatically
switch to Welch's t-test with adjusted degrees of freedom!
🏔️ Two Mountain Peaks in Fog: Why Pooled Variance Fills the Denominator
The physical distance between two summit peaks (¯X₁ - ¯X₂) represents the Signal we aim to prove. But valley fog
enshrouds the terrain—representing individual differences within each group. Merging these independent student
variances creates the Pooled Standard Error. The t-statistic measures how many fog-thickness units separate the two
summits.
📐 Mathematical Structure (SNR)
t = (¯X₁ - ¯X₂) / SE_pooled
Numerator is clean mean delta; denominator is sample-
weighted pooled error. Degrees of freedom df = n₁ + n₂ - 2.
🎯 3-Second Heuristic (|t| > 2.0)
|t| > 2.0 → p < .05 Cleared
Signal is over twice as strong as noise; with 95% confidence,
these two populations represent genuinely distinct mountains!
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 45
48
4.7 PAIRED T-TEST
4.7 Paired t-tests: How Within-Subject Comparison Erases Individual Noise
The Magic of Before & After: Subtracting Baseline Constitution to Triple Statistical Power
Imagine testing 50 subjects before and after an energy drink intervention. Applying an independent t-test causes
catastrophic power loss because individual differences in innate metabolic speed balloon the denominator. Paired t-
tests contrast each participant against their own historical baseline, evaporating inter-individual noise to zero.
[Figure 4-4] Independent vs. Paired t-test Geometric Contrast: While independent designs struggle to distinguish peaks
through heavy individual-difference fog, paired tests track within-subject difference scores (Δ), dissolving the fog entirely.
🏃 Mandatory Selection Criteria for Paired t-tests (Within-Subjects)
• Target Cohort: Same individuals measured twice across time (Pre vs. Post), or 1:1 matched pairs (identical twins,
matched IQ/age twins).
• Core Mechanic: Transforms two separate score distributions into a single vector of difference scores (Δ = After -
Before), collapsing into a 1-sample t-test (df = N - 1)!
• Tremendous Statistical Power: Erasing individual baseline differences shrinks the denominator standard error (SE),
enabling detection of subtle clinical gains unnoticed by independent tests.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 46
49
4.8 MULTIPLE COMPARISONS
4.8 Comparing Three or More Groups: The Alpha Inflation Disaster
Coin Tossing and the Explosion of Type I Error: The Peril of Repeated Pairwise Tests
When evaluating three cohorts—Drug A, Drug B, and Placebo C—novice analysts often suggest: "Why
not run three separate t-tests: A vs B, B vs C, and A vs C?" In scientific research, this constitutes a fatal
methodological flaw known as Familywise Error Rate (FWER) Inflation.
🪙 The Coin Toss Metaphor: Why 5% Risk Balloons to 14.3%
Tossing a fair coin yields heads with a 50% probability. What is the chance of getting heads at least once across
three consecutive tosses? It surges to 87.5%!
Statistical testing behaves identically. While a single test caps false positive risk at 5% (α = .05), running three tests
reduces the probability of remaining error-free to 0.95 × 0.95 × 0.95 = 85.7%. Consequently, the risk of falsely
declaring a non-existent effect triples to 14.3%!
📈 Familywise Error Rate (FWER) Formula Across k Groups
FWER = 1 - (1 - α)^c [Comparisons c = k(k-1)/2]
• 3 Groups (3 comparisons): Error rate reaches 14.3% (scientific rigor compromised)
• 4 Groups (6 comparisons): Error rate reaches 26.5% (1 in 4 findings is a false alarm)
• 5 Groups (10 comparisons): Error rate reaches 40.1% (tantamount to flipping a coin)
🛡️ Fisher's Breakthrough: Analysis of Variance (ANOVA)
To protect research against error inflation, Sir Ronald Fisher developed an overarching Omnibus Test capable of testing
differences across multiple groups within a single 5% error ceiling: Analysis of Variance (ANOVA).
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 47
50
4.9 PARTITIONING VARIANCE
4.9 Partitioning of Variance: Why Comparing Means Is Named 'Analysis of
Variance'
The Most Brilliant Paradigm Shift in Statistics: How Variance Ratios (F) Reveal True Group Separation
Most students stall here: "If we want to test whether three group means differ, why is the technique called 'Analysis of
Variance' (ANOVA) rather than 'Analysis of Means'?" Ronald Fisher's profound breakthrough was: "To determine
whether group means are truly separate, we must compare the ratio between two distinct types of variance—
Between-Group Variance (Signal) versus Within-Group Variance (Noise)!"
[Figure 4-5] ANOVA Prism and Variance Partitioning: Total experimental variation (SST) refracted cleanly into treatment
effect signal (SSB) and random within-group noise (SSW).
🌟 Slice 1. Between-Group Variance (SSB)
Spread caused by treatment interventions (new drugs,
teaching methods) pulling group means away from the
grand mean (Signal).
💨 Slice 2. Within-Group Variance (SSW)
Spread among subjects receiving the identical treatment
due to innate biological differences and environmental
noise (Error).
💡 Fisher's Insight: Analyzing Variances to Test Means!
"If treatment variance (SSB) significantly dwarfs natural biological noise (SSW), the group means cannot possibly be
identical—they must be pulled far apart!" By analyzing variance ratios, we establish mean differences.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 48
51
4.10 SUM OF SQUARES & ANOVA FAMILY
4.10 Sum of Squares Decomposition (SST = SSB + SSW) & ANOVA Family
Compass
Budget Partitioning Analogy and Selecting Between One-Way, Two-Way, and Repeated Measures ANOVA
Across 120 subjects, individual outcomes scatter widely. The sum of all squared deviations from the grand mean is
the Total Sum of Squares (SST). Like a household budget, this total variation divides cleanly into exactly two pieces
without a single lost cent.
[Figure 4-6] Light Refraction and Sum of Squares Partitioning: Just as a prism separates white beam energy (SST) into
treatment red (SSB) and noise blue (SSW), ANOVA partitions variation into signal and error.
🧭 The 3 Core ANOVA Models Every Researcher Must Master
• 1. One-Way ANOVA: 1 factor, 3 or more independent groups (e.g., Comparing Curriculum A vs. B vs. C).
• 2. Two-Way ANOVA: 2 factors simultaneously (e.g., 3 Curricula × 2 Genders). Evaluates Main Effects and Interaction
Effects (synergies) that 1-factor tests miss completely!
• 3. Repeated Measures ANOVA: Same participants tested across 3+ intervals (Pre, Mid, Post). The multi-group extension
of paired t-tests, scrubbing individual baseline differences.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 49
52
4.11 DEGREES OF FREEDOM
4.11 The Elegance of Degrees of Freedom (df)
Why Divide by N - 1 Rather Than N? The Musical Chairs Principle of Statistical Constraints
One of the most perplexing concepts encountered in mathematical statistics is Degrees of Freedom
(df). Why do sample variance formulas divide by n - 1 instead of n? The game of musical chairs provides
an intuitive answer.
🪑 Five Chairs and Five Students Game
Imagine five empty chairs in a classroom, with five students entering sequentially:
• Student 1: Can freely select any of the 5 chairs (df = 1)
• Student 2: Freely chooses from the remaining 4 chairs (df = 2)
• Students 3 & 4: Freely choose from remaining chairs (df = 4)
• Final Student 5: Does this student possess freedom of choice? None whatsoever! They must sit in the single chair
left.
💡 The Constraint of the Mean: The Final Value Loses Autonomy
If three numbers have a fixed mean of 10 (¯X = 10, Sum = 30), choosing 5 and 15 for the first two values leaves the
third value unconditionally fixed at 10. Imposing a sample mean as an anchor strips away exactly 1 degree of
freedom, restricting independent values to N - 1.
⚖️ Mean Squares (MS): Calculating Fair Variance per Unit
Raw Sum of Squares inflates automatically with larger sample sizes. Dividing each SS component by its corresponding
degrees of freedom yields Mean Squares (MS = SS / df), standardizing variance per degree of freedom for an unbiased
F-ratio test.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 50
53
4.12 F-RATIO MECHANICS
4.12 The Birth of the F-Ratio: Treatment vs. Error
The Duel on the Scales: Why the F-Value Hovers Near 1.0 Under the Null Hypothesis
With treatment signal variance (MSB) and random individual error variance (MSW) computed,
hypothesis testing culminates in a single definitive ratio. This is Fisher's F-Ratio.
[Figure 4-7] Musical Chairs Degrees of Freedom and the F-Ratio Balance: The N - 1 constraint mechanism, and
how the scale tips when treatment variance (MSB) overwhelms error noise (MSW), propelling the F-ratio past 1.0
toward rejection.
⚖️ The Fundamental F-Ratio Formula
F = MSB / MSW = (Between-Group Treatment Signal) / (Within-
Group Error Noise)
Zero Treatment Effect: F ≈ 1.0
Between-group differences mirror random background
noise. Numerator and denominator cancel out, holding F
near 1.0. Null hypothesis sustained!
Substantial Treatment Effect: F >> 1.0
Treatment effect (MSB) outweighs noise (MSW) by 5- to
10-fold. The balance tips decisively, yielding p < .001 and
rejecting the null!
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 51
54
4.13 POST-HOC ANALYSIS
4.13 Unmasking the Culprit: Bonferroni vs. Tukey HSD
The Police Lineup Metaphor: "A Crime Was Committed, but Which Suspect Is Responsible?"
Achieving a statistically significant F-value (p < .05) is exciting, but ANOVA carries a fundamental
blindspot: it reveals that a difference exists somewhere, but does not disclose which specific pairs
differ. Post-Hoc Tests act as specialized detectives to pinpoint exact pairwise contrasts.
🕵️ The Three-Suspect Police Lineup Analogy
Testing Control, Caffeine, and Energy Gel cohorts resembles a station alarm ringing: "At least one intervention
produced a measurable effect!" Yet whether Caffeine or Energy Gel drove the outcome remains unresolved. Post-
hoc procedures interrogate each pair individually under controlled error conditions.
🛡️ Bonferroni Correction
Threshold Division: α / c
Divides 0.05 by 3 comparisons, requiring p < .0167.
Straightforward
to
implement,
but
grows
overly
conservative as comparison counts escalate.
👑 Tukey's HSD
Honestly Significant Difference
The gold standard in modern academic reporting,
maintaining statistical power while strictly bounding
familywise error at 5%.
📊 Hands-On Data Post-Hoc Summary
• Control vs. Caffeine: t = 4.21, p < .001 (Caffeine significantly accelerates responses)
• Control vs. Energy Gel: t = 7.35, p < .001 (Energy Gel delivers highest performance gain)
• Caffeine vs. Energy Gel: t = 3.14, p = .0022 (Energy Gel significantly outperforms Caffeine)
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 52
55
4.14 P-VALUE MISCONCEPTIONS
4.14 Fatal Misconceptions and Limits of the p-Value
The Radar and Mosquito Wing Analogy: Escaping the N = 100,000 Sample Size Mirage
Encountering p < .05 in a statistical report frequently sparks jubilation: "Significant! The study
succeeded!" Yet widespread misuse surrounds the p-value; it conveys nothing regarding magnitude,
practical value, or scientific importance.
🔬 The Ultra-Sensitive Radar Metaphor: Sample Size Dominance
A mosquito flutters its wings in a room. To human senses, no breeze is perceptible. But deploy a multi-million-dollar
military Doppler radar (sample size N = 100,000), and the sensor triggers an alarm: "Wind detected with 99.999%
certainty (p < .001)!"
The existence of air displacement is technically verifiable (p < .001), yet does this breeze cool an occupant or
power a windmill? Absolutely not. In massive cohorts, even microscopic trivialities trigger p < .001, creating an
illusion of substantial impact.
📜 Official Statement of the American Statistical Association (2016)
"A p-value measures only the incompatibility between data and a specified statistical model. Scientific conclusions
and business decisions should never rely solely on whether a p-value passes an arbitrary threshold. Researchers
must report Effect Sizes."
🎯 Three Commandments for Responsible Inference
1. p < .05 indicates an effect is unlikely due to chance, never that the effect is large.
2. p = .049 and p = .051 represent practically identical evidence, not success vs. failure.
3. Rigorous researchers always substantiate p-values with Effect Sizes (Cohen's d, η²).
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 53
56
4.15 EFFECT SIZE
4.15 The True Measure: Effect Size (Cohen's d, η²)
The Measuring Tape: Assessing Real-World Thickness Beyond Sample Size Distortions
Free from the magnification distortions of sample size, Effect Size answers the pivotal question: "How
large is the difference in reality?" It provides an objective metric unaffected by whether a sample
comprises 10 or 100,000 subjects.
[Figure 4-8] The Microscope p-Value Trap vs. The Tape Measure Effect Size: Large cohorts (N = 100,000) inflate
microscopic differences into significant p-values, whereas effect sizes (Cohen's d, η²) accurately gauge physical girth
without sample size bias.
For t-Tests: Cohen's d
d = (¯X₁ - ¯X₂) / s_pooled
Expresses difference in standard deviations: 0.2 indicates
small, 0.5 medium, and > 0.8 represents a large effect.
For ANOVA: Eta-Squared (η²)
η² = SSB / SST
Proportion of total variation explained: .01 small, .06 medium,
and > .14 signifies a powerful effect.
📝 Benchmark APA 7th Edition Reporting Standard
"A one-way ANOVA demonstrated a statistically significant effect of beverage condition on reaction time, F(2, 117) = 27.99,
p < .001, η² = .324. The eta-squared value indicates that 32.4% of total reaction time variance is accounted for by beverage
consumption, representing a large effect size."
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 54
57
4.16 AI GOLDEN PROMPTS
4.16 Generative AI and Model Decoding: Golden Prompts 4-1 & 4-2
Do Not Memorize Formulas: Transforming AI into Your Dedicated 1-on-1 Statistics Tutor
Generative AI serves as an indispensable tutor for researchers navigating mathematical foundations.
When guided by domain-informed prompts, AI systematically derives variance decompositions and
cross-verifies statistical computations.
Golden Prompt 4-1
Signal-to-Noise Ratio (SNR) Decomposition & Post-Hoc Engine
"Act
as
an
expert
professor
of
biostatistics.
Based
on
the
3-group
experimental
dataset
(16_game_reaction_time_ch4.csv), derive the underlying mechanics step-by-step:
1. Decompose Total Sum of Squares (SST) into Between (SSB) and Within (SSW), demonstrating exact conservation
(SST = SSB + SSW).
2. Calculate Mean Squares, the F-ratio (MSB / MSW), and Eta-Squared (η²), explaining each mathematically.
3. Perform Bonferroni and Tukey HSD post-hoc tests to identify specific pairwise differences."
Golden Prompt 4-2
APA 7th Results Narrative & Effect Size Reporting Generator
"Using the derived one-way ANOVA metrics, synthesize an academic Results section strictly adhering to APA 7th
guidelines:
1. Format all statistics with appropriate italicized notation: F(df_b, df_w) = XX.XX, p = .XXX, η² = .XXX.
2. Detail pairwise post-hoc contrast results with accompanying Cohen's d estimates.
3. Conclude with an analytical statement contextualizing practical impact beyond nominal p-values."
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 55
58
4.17 MACHINE-READABLE SCHEMA
4.17 Machine-Readable JSON Schema & Python Pipeline
Bridging Human Rigor and AI Execution: 17_statistical_model_schema.json
To eliminate hallucinations during human-AI collaboration, hypotheses and mathematical specifications
are codified into standardized JSON structures, enabling deterministic execution across workflows.
// 17_statistical_model_schema.json Excerpt
{
"model_name": "One-Way ANOVA & Signal-to-Noise Engine",
"dependent_variable": { "name": "reaction_time_ms", "scale": "Ratio" },
"factor": { "name": "drink_group", "levels": ["Water", "Caffeine", "EnergyGel"] },
"mathematical_mechanics": {
"variance_decomposition": "SST = SSB + SSW",
"f_ratio": "MSB / MSW",
"effect_size": "eta_squared = SSB / SST"
},
"post_hoc": ["Bonferroni", "Tukey_HSD"]
}
💻 Python Mathematical Pipeline (19_verify_statistical_mechanisms.py)
The companion script (File 19) utilizes Pandas and SciPy to execute SST decomposition, compute degrees of
freedom, extract F-statistics, and output Tukey HSD post-hoc tables in under 0.05 seconds, outputting rich
diagnostics to the terminal.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 56
59
4.18 HANDS-ON WORKSHOP
4.18 Hands-On Lab: Reader Kit and 4-Step Execution Guide
A Complete Verification Workflow Achievable in Under 5 Minutes
📦 Chapter 4 Lab Kit Package Contents
• 16_game_reaction_time_ch4.csv: Empirical records of 120 subjects across 3 beverage cohorts
• 17_statistical_model_schema.json: Machine-readable ANOVA and variance decomposition schema
• 18_AI_Golden_Prompts_Ch4.md: Verbatim Golden Prompts 4-1 & 4-2 documentation
• 19_verify_statistical_mechanisms.py: Automated script for variance and post-hoc execution
• 20_study_guide_and_ch4_solutions.md: Problem set keys and algebraic derivations
🛠️ 4-Step Practical Execution Protocol
STEP 1. Download Lab Assets: Retrieve the 5 files from the repository and place them inside your local
stats_ch4/ directory.
STEP 2. AI Hypothesis Consultation: Submit [Golden Prompt 4-1] into ChatGPT or Claude to explore the
conceptual mechanics of the dataset.
STEP 3. Run Verification Script: Open your terminal and trigger the automated pipeline:
python3 19_verify_statistical_mechanisms.py
STEP 4. Cross-Validate Diagnostics: Verify terminal output against Figure 4-9 on the following page (F=27.99,
p<.001, eta²=0.324).
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 57
60
4.19 VERIFICATION & SUMMARY
4.19 Verification Guide and Checklist: Forward Look
Execution Benchmark, 4-Point Self-Diagnostic Checklist, and Chapter 5 Preview
[Figure 4-9] Python Statistical Engine Execution Benchmark: One-way ANOVA table (F=27.99, p<.001), 3-cohort
Bonferroni post-hoc significance thresholds, and Eta-Squared (η²=.324) calculation.
📋 Chapter 4 Self-Diagnostic Checklist
☑ SST = SSB + SSW Equivalence: Was total variation cleanly partitioned into treatment and error?
☑ Degrees of Freedom Audit: Do values align: Between = 2 (3-1), Within = 117 (120-3), Total = 119?
☑ F-Ratio Confirmation: Does F(2, 117) = 27.99 comfortably reject the null hypothesis?
☑ Post-Hoc Verification: Is the hierarchy Water < Caffeine < Energy Gel verified at p < .01?
🚀 Looking Ahead: Chapter 5 Parametric Modeling & Multiple Regression
Having mastered foundational mathematical mechanics, Chapter 5 elevates your analysis into multivariate space:
navigating 3D regression planes, Two-Way ANOVA interaction synergies, and NLP sentiment scores.
CHAPTER 04 · STATISTICAL MECHANISMS · PAGE 58
61
제4장 기술 통계와 탐색적 데이터 분석(EDA) 아키텍처신호 대 잡음비(SNR)와 데이터 중심경향치 및 산포도분산 시소 모델 — 편차 제곱합과 분산의 기하학적 균형스프 한 숟가락의 표집 오차 — 표본 크기와 모평균 추정의 신뢰도기술통계 핵심 요약량 및 사분위수(IQR) 이상치 탐지 콘솔
🇰🇷 한국어 정규 에디션 (교보문고 바로출판 POD 120p 완제 원문) 🇰🇷 한국어 에디션 (KO) 🇺🇸 Global Edition (EN) CHAPTER 05 AI를 활용한 핵심 모수 통계 추출과 결과 해석 다중 선형 회귀부터 Two-Way ANOVA, 정밀 데이터 테이블 설계 및 학술 차트 시각화까지 [그림 5-0] AI 다변량 통계 분석 연구실: 복잡한 수학 공식 대신 3차원 회귀 평면과 감성 텍스트를 시각화하여, AI와 함께 변수 간의 숨은 인과 관계를 직관적으로 해독하는 최첨단 연구 환경. 🎯 제5장 핵심 학습 목표 (고등학생도 3초 만에 꿰뚫는 데이터 과학의 핵심) 1. 다중 회귀의 입체적 기하학: 점들을 잇는 단순한 직선 하나를 넘어, 여러 원인이 얽힌 3차원 공간에서 최적의 '회귀 평면'을 찾는 원리를 이해합니다. 2. 회귀계수의 본질: 비표준화 계수 B의 실생활 단위 의미와 표준화 계수 β를 통해 어떤 원인이 가장 강력한지 서열을 매깁니다. 3. 5단계 통계 판별 로드맵: 연구 질문과 변수 유형에 따라 t-검정, ANOVA, 다중회귀를 단 3초 만에 판별하는 결정 트리를 마스터합니다. 4. 합리적 데이터 구조 & 구글 드라이브 실습: Long vs Wide 포맷 설계 및 구글 드라이브 실습 키트(CSV/파이썬)의 1클릭 실행법을 체득합니다. 5. 300 DPI 출판용 그래프 시각화 & AI 프롬프트: 바이올린 플롯, 신뢰대역 회귀도, 잔차 진단도를 파이썬과 AI로 추출합니다. PART 02 · STATISTICAL MECHANISMS & AI DECODING 62 5.1 MULTIVARIATE MODELING 5.1 단순 선형에서 다중 회귀로: 한 걸음 더 들어가는 다변량 모델링 원인이 단 하나뿐인 세상은 없다: 1차원 직선에서 3차원 '회귀 평면'으로의 도약 여러분이 오늘 본 시험 점수는 단순히 어제 책상에 앉아 공부한 ...
🇰🇷 한국어 정규 에디션 (교보문고 바로출판 POD 120p 완제 원문) 🇰🇷 한국어 에디션 (KO) 🇺🇸 Global Edition (EN) CHAPTER 01 가설 수립과 변수 명세 일상의 막연한 호기심을 AI가 이해하는 날카로운 데이터 잣대와 조작적 정의로 바꾸기 [그림 1-0] AI와 함께하는 신나는 연구 탐험: 일상의 사소한 호기심도 AI와 함께 올바른 잣대를 세우면 위대한 과학적 발견이 됩니다. 🎯 제1장 핵심 학습 목표 (고등학생부터 연구원까지 누구나 꿰뚫는 원리) 1. AI의 거짓말(환각) 차단하기: 왜 AI에게 "이 앱 공부에 도움 돼?"라고 물으면 엉터리 답을 내놓는지, 그 원인과 '조작적 정의'의 위력을 배웁니다. 2. 검은 백조와 탐정의 원칙: 과학적 가설은 "내 생각이 맞다"고 우기는 게 아니라, 법정의 '무죄 추정'처럼 "틀렸음을 증명할 예외(반증)"를 찾는 게임임을 이해합니다. 3. 개구리 경주와 4대 척도: 1등과 2등의 점수 차이는 1점일 수도, 50점일 수도 있다! 왜 등수의 평균을 구하면 AI가 망가지는지 4가지 숫자 계급을 마스터합니다. 4. 아이스크림의 거짓말(교락 변수): 아이스크림 판매량과 물놀이 익사 사고가 함께 늘어난다고 해서 아이스크림이 범인일까? 숨어있는 진짜 범인(날씨)을 밝혀냅니다. 5. AI 골든 프롬프트 1-1 실전 활용: 내가 가진 사소한 아이디어를 입력하여, 결측치 없는 머신 판독형 JSON 연구 계획서와 가상 데이터셋을 즉시 뽑아냅니다. PART 01 · FOUNDATION ARCHITECTURE · PAGE 7 7 SECTION 1.1 1.1 왜 AI에게 "이 앱 공부에 도움 돼?"라고 물으면 안 될까? 주관적 형용사의 함정과 기계를 작동시키는 '조작적 정의(Operational Definition)' 친구들과 주말...
🇰🇷 한국어 정규 에디션 (교보문고 바로출판 POD 120p 완제 원문) 🇰🇷 한국어 에디션 (KO) 🇺🇸 Global Edition (EN) APPENDIX A 부록 A. 통계 검정 선택 원페이지 결정 로드맵 연구 질문, 종속변수 척도, 집단 수, 정규성 만족 여부에 따른 3초 통계 모델 결정 트리 연구 현장에서 어떤 분석 기법을 선택해야 할지 혼란스러울 때, 아래의 3단계 의사결정 순서도를 따라가면 단 3초 만에 최적의 모수/비모수 통계 모델을 선택할 수 있습니다. 연구 질문 및 목적 독립변수 (X) 종속변수 (Y) 정규성 만족 (모수 통계) 정규성 위반 (비모수 대안) 두 집단 평균 비교 (서로 다른 사람) 범주형 (2집단) (예: AI군 vs 통제군) 연속형 (등간/비율) (예: 점수, 완료율) 독립표본 t-검정 (Independent t-test) 맨-휘트니 U 검정 (Mann-Whitney U) 동일 집단 전후 비교 (동일인의 사전-사후) 범주형 (2시점 반복) (예: 교육 전 vs 교육 후) 연속형 (등간/비율) (예: 반응시간 차이) 대응표본 t-검정 (Paired t-test) 윌콕슨 부호순위 검정 (Wilcoxon Signed) 세 집단 이상 비교 (1개 요인) 범주형 (3집단 이상) (예: A vs B vs C) 연속형 (등간/비율) (예: 학업 성취도) 일원 분산분석 (One-Way ANOVA) 크루스칼-월리스 검정 (Kruskal-Wallis H) 두 요인의 교차 효과 (2×2 요인 설계) 범주형 2개 요인 (예: 처치 × 숙련도) 연속형 (등간/비율) (예: 시험 점수) 이원배치 분산분석 (Two-Way ANOVA) 비모수 순위 분석 또는 붓스트래핑 (5,000회) 연속형 변인 간 예측 (인과 및 영향력 검증) 연속형 1개 이상 (예: 사용시간, 감성점수) 연속형 (등간/비율) (예: 최종 성과 지표) 다중 선형 회귀분석 (Multiple Regression) 강건 ...